
9 月 6 日,纽约大学数学家 Tristan Buckmaster 接到了一通让他坐立难安的电话。
电话那头是 OpenAI 的人员。对方告知,他们的内部模型在著名的 Navier–Stokes 方程上取得了一项数学突破。这个方向,恰好与 Buckmaster 团队长期攻关的课题高度重合。
Buckmaster 当场追问:自己团队几个月来的核心推导草稿,一直完整保存在 Codex 账号里,OpenAI 到底有没有调用过这些内容?
他用课题经费给商业 AI 工具付费,依赖这套工具辅助推演。结果一转眼,卖工具的公司带着一套重磅成果反客为主,找上了门来。
公开发酵后,这件事很快被情绪化地解读为“数学家把机密喂给 AI,被供应商抢先发表”。但在事实面前,事情并没有这么简单。
Buckmaster 在公开声明中承认,他无法证实自己的数据确实被模型或人员调用过。OpenAI 也在 9 月 10 日的官方更新中明确否认:经内部调查,Buckmaster 在公告前两个月内的所有 Codex 记录,都不可能影响该研究系统,包括通过模型训练产生影响。
仅凭双方发布推文的时间先后,无法断定存在抄袭。
但这起风波真正刺痛科研与工程团队的地方,比“数据有没有被偷看”要深得多:即便在技术上做到了百分之百的数据隔离,提供工具的厂商,依然在事实上变成了你的直接竞争对手。
OpenAI 在自己的公告里写得很坦白:9 月 1 日,在听到业内有数学难题取得突破的传闻后,他们立刻调用内部未公开的强大模型,尝试攻克同一个千禧年难题。
科学界的公开难题,谁都有权探索。要求一家前沿 AI 实验室永远避开所有付费客户正在研究的领域,既不现实,也不合逻辑。
但很多研发者容易混淆一个关键事实:购买工具的 API 调用权限,与获得平等的科研合作,完全是两码事。你订阅了某家厂商的服务,并不代表对方会把最顶尖的能力同步开放给你,更不代表双方达成了某种研究同盟。
“不用我的数据训练”和“不会与我竞争”,回答的是两个完全不同的问题。
前者是数据隐私与合规层面的承诺,后者是商业战略与研发布局的自由。
两者完全可以同时成立:供应商哪怕一条你的私密材料都没碰,依然能凭借更先进的未公开模型、更庞大的算力集群,以及内部同方向的研究团队,在完全相同的赛道上和你同时冲刺。
如果只盯着“数据有没有泄露”,就会忽视这场冲突背后的根本质变:当工具开始介入思考本身,提供商与使用者的关系就已经变了。
一个拼写检查工具只需要看几个孤立的单词,但能参与推导演算、编写算法的 Agent,必须吃下深度的上下文。为了让 AI 理解自己到底卡在哪里,研究者会把尚未成型的推导假设、半成品实验和试错日志全盘交出。
这些资产的敏感度完全不同。公开论文谁都能查到,一段简单的报错代码也不涉及秘密;但某次失败为什么排除了一个技术路线、某组异常数据为什么值得继续深挖,往往是整个团队最核心的研究壁垒。
当这些上下文持续涌入对话框,“我们只是买了个软件”的心理防线就彻底失效了。
如果团队进一步接受了厂商技术人员的早期支持,边界会变得更加模糊。协助排查接口问题的驻场工程师,是在修 Bug,还是在顺带调研前沿赛道的痛点?你是在测试早期模型,还是在不知不觉中充当了对方验证技术可行性的免费测试员?
等到成果快要见分晓时再去厘清权责,往往已经太迟了。谁先公布、谁算首创、谁拥有主导权,必然沦为扯不清的泥潭。
因噎废食全面停用 AI 并不现实。工具带来的推演效率杠杆是真实的,彻底不用只会把速度优势白白让给同行。
面对这种不对称的竞争,真正有效的手段不是指望供应商的职业操守,而是靠工程手段建立物理防御。
公开文献与通用代码,可以放手交给公有商业模型处理。但未公开的核心假设验证、关键推导跃迁和原始实验记录,必须建立严格的本地双轨隔离。哪怕是在同一家厂商的产品体系内,也不能因为企业级 API 有免训练承诺,就默认网页端或早期测试账号也享有同等保护。
更关键的是守好本地的版本凭证链。
核心灵感是在哪一天形成的、关键推导是由人类成员迈出的还是由模型建议的、Agent 具体提供了哪些修改片段,都必须在完全由自己掌控的本地版本管理系统中留下不可篡改的提交历史。
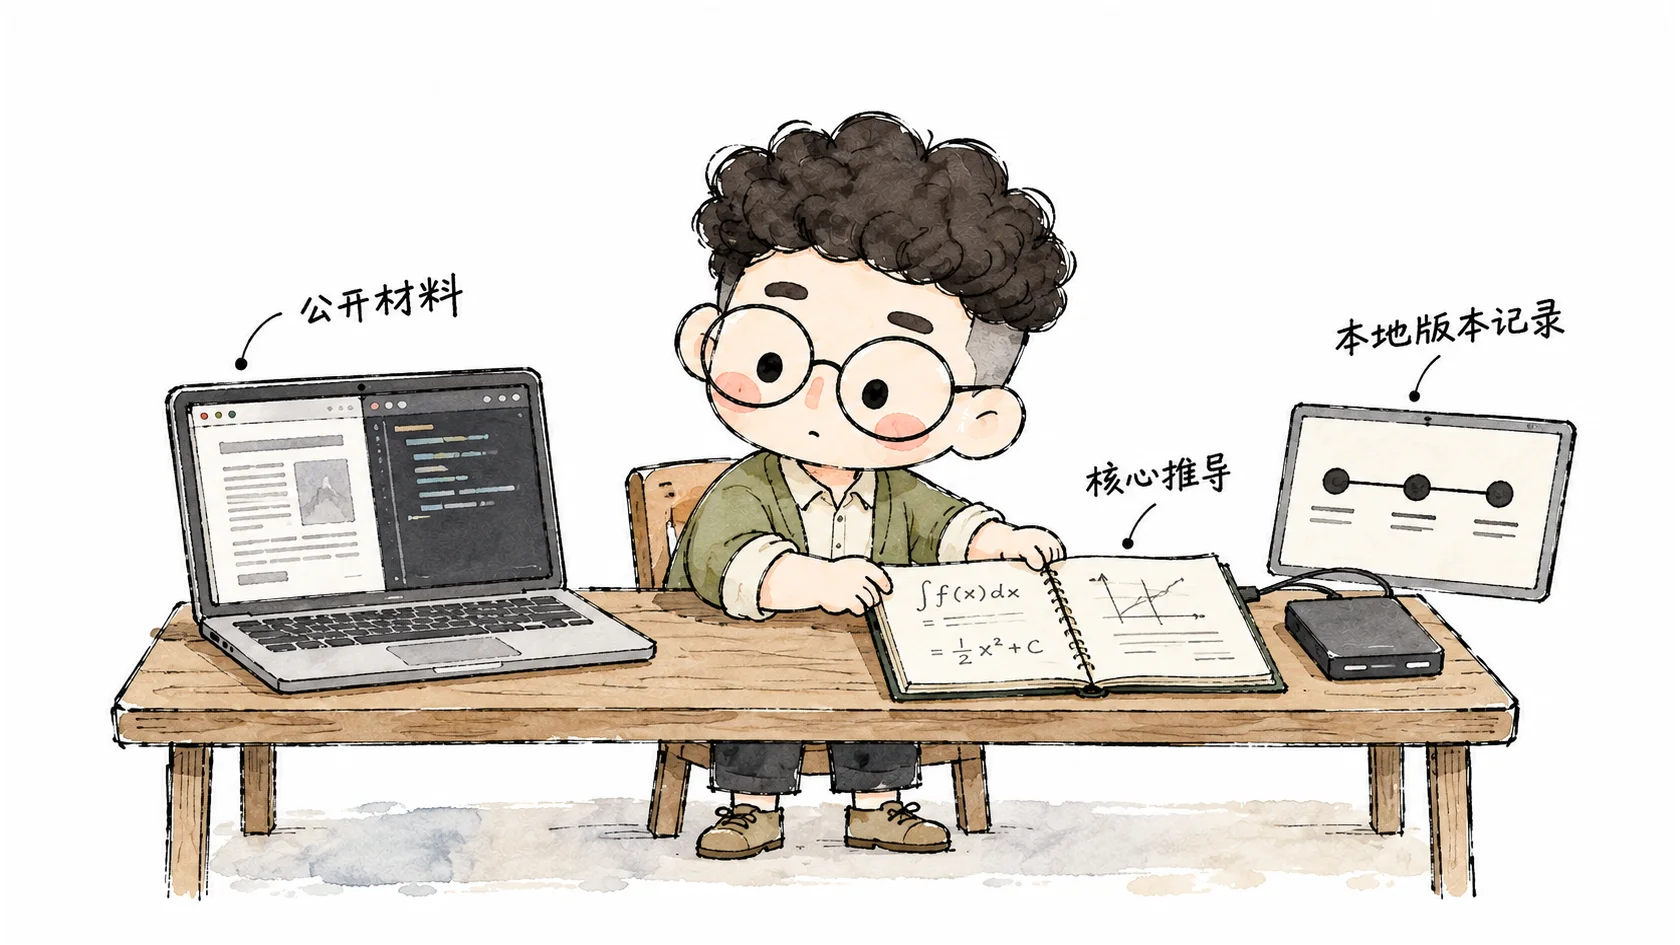
这未必能阻止别人做相同的研究,但至少能在成果归属遭遇质疑时,给出无可辩驳的证据链。
买工具不是认同盟。工具越聪明、介入业务越深,你就越要把它当成一个随时可能在终点线前超车的潜在对手。