
35 小时,79 次提交,净增近 7.5 万行代码。
Flask 作者 Armin Ronacher 曾经公布过一场长程编程实验:他给新一代模型留了极高的自主权,让它尝试给 Python 解释器加上虚拟线程和词法作用域。漫长的运行后,Armin 最终主动按下了终止键。几万行代码的轰鸣运转,没有换来哪怕一行能实际交付的有效改动。
很多人并不怀疑新模型在基础素质上的飞跃:推理链条更长、系统级调度更熟练、具备不知疲倦的超长耐力。但当这些能力落进严肃的软件工程现场时,换来的产出收益却往往不成比例。
这道出了许多重度开发者的真实困惑:你可以发自内心地赞叹新模型的惊艳演进,却依然会在主力开发流里,坚定地把它换回旧模型。
过去我们最头疼的是 Agent 走两步就卡住,频繁需要人工介入。如今模型的长程续航能力大幅提升,新的负担却悄然浮现:你必须花大量时间去分辨,它到底是在攻克深水区的难题,还是在死胡同里疯狂绕远路。单看动辄几个小时的运行时长,根本分不清这两种情况。
严肃工程对“交付”的定义,远比跑通单测苛刻得多。改动必须自然融入仓库既有的设计范式,逻辑要能向 Reviewer 讲清意图,更不能给下一次迭代挖坑埋雷。这些隐性约束从不会出现在跑分榜单或宣发视频里,却扎扎实实横亘在每一次后续维护中。
模型独立完成任务的耐力,和人类接手这批产物的代价,需要分开计算。
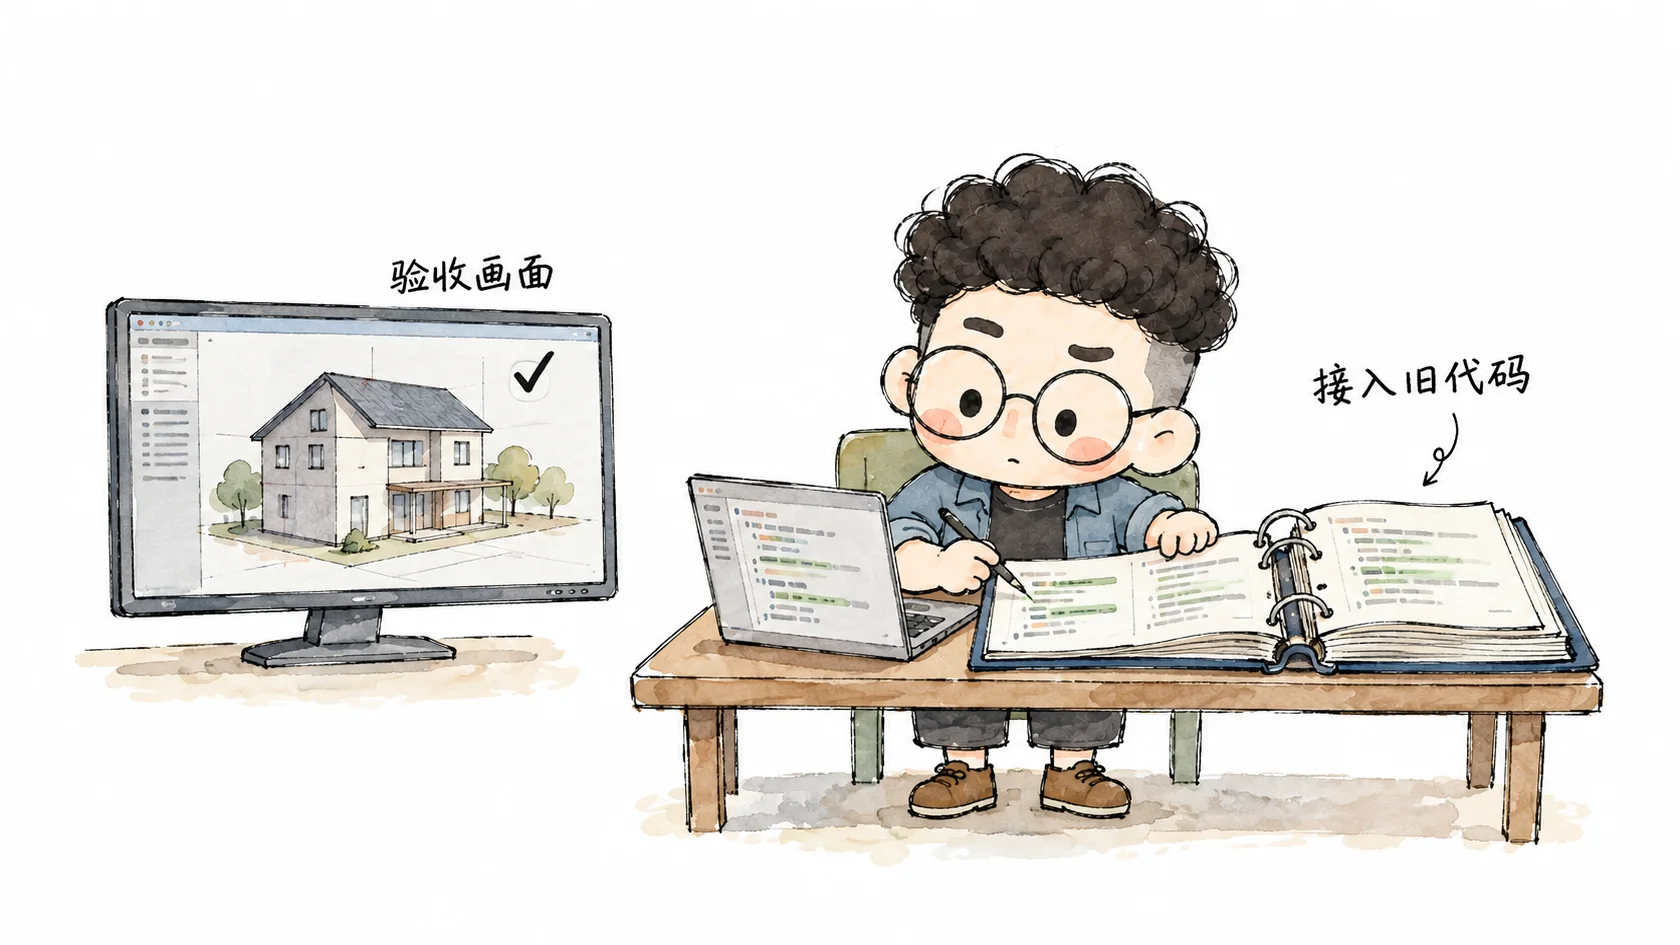
在厂商的宣发案例里,模型展示了用 Blender 自动构建三维房屋的本领:通过 Python API 生成几何体、打光、调材质,再借助视觉反馈闭环调整细节。
对这种任务,代码只是实现视觉效果的中间脚手架。使用者最关心的是画面是否合格、家具摆放是否合理、光影是否自然。只要最终渲染出来的房子挑不出毛病,生成的 Python 脚本哪怕多拐了三个弯、多写了几段冗余逻辑,也无伤大雅。
但维护真实生产系统的团队,面对的完全是另一套法则。一次看似简单的修改,必须严丝合缝地融入几年前的历史代码,照顾业务里那些从未写进文档的隐性约定,还要随时准备被其他同事接手审查。两种场景都在让模型写代码,但在工程天平上的验收权重有着天壤之别。
当前沿大模型的通用版图不断扩张,“更强”这个词就必须加上严格的工程限定语。模型更懂图像、更擅长操作桌面、更会摆弄多媒体工具,是了不起的技术突破;但这并不意味着,它在人类开发者日夜面对的代码泥潭里,也变得同样顺手。
一次软件演示,很容易结束在功能跑通的掌声里。但对真实的软件工程来说,后续的维护与接管才刚刚拉开序幕。
模型顺手多写了几个辅助工具函数,单看逻辑完全成立。但它是否重复造了现成的轮子?有没有悄悄引入一套别扭的私有状态或错误处理模式?这种“孤岛式代码”在仓库里累积得越多,项目的长期认知负荷就越重。
有人会设想:既然 AI 越来越强,以后的维护全扔给它不就行了?
这种设想忽略了一个现实代价:软件不仅要在平时跑通,更要在凌晨线上出故障时被迅速定位。只要系统最终还需要人类工程师来对业务结果兜底,代码的可理解性成本就永远无法一笔勾销。
即使退一步,真的把维护全权交给 Agent,运行、验证和反复修补同样有极高的时间与算力开销。没有人逐行读代码,不代表不需要有人为“系统正在做正确的事”提供担保。
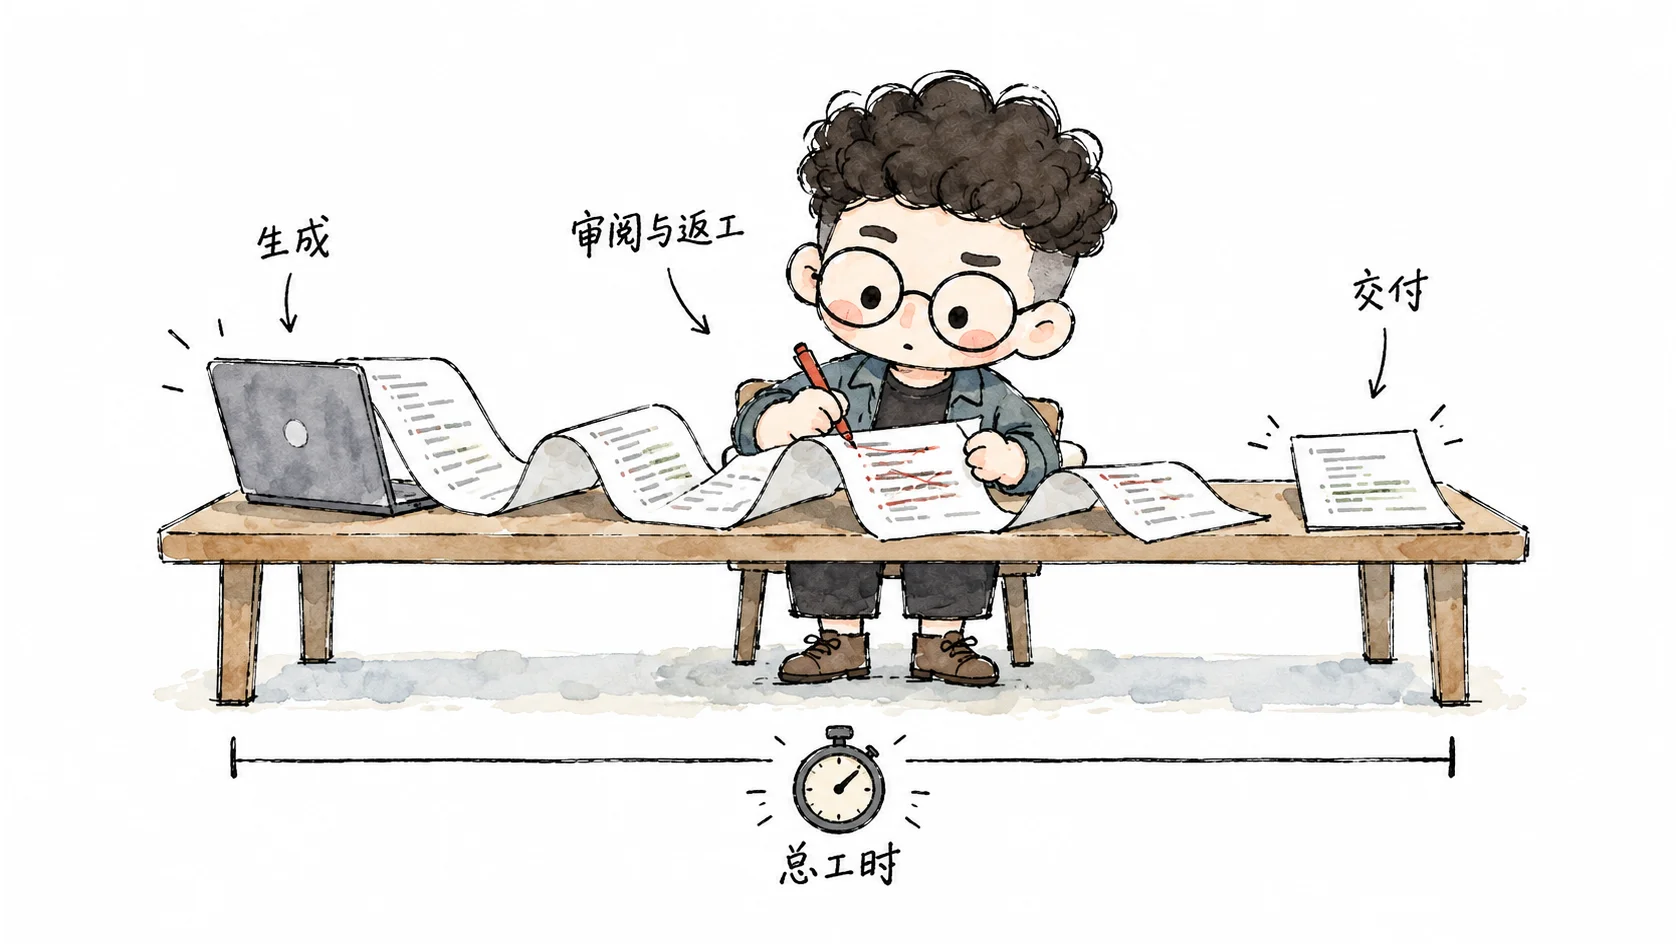
因此,评估一次模型升级的真实价值,计时绝不能在 Agent 提示“完成”时按停。后续人类审阅代码花掉的时间、排查副作用耗费的精力,以及为了纠正它的过度设计而反复撤回的改动,必须全部算进真实的交付账本。
面对层出不穷的新模型,尝鲜是本能,但完全没必要把主力流水线全盘换掉。
更稳妥的试金石,是挑选一个团队最近刚做过、边界清晰的真实需求,在相同的代码基线上做回放对比。保持上下文、工具权限与验收标准完全一致,重点记下为了适应新模型,人类额外做了多少提示词干预和代码清洗。只看第一次生成,会漏掉中途的死循环;只看最终是否跑通,则会掩盖过程中的隐性代价。
如果新模型在探索陌生技术栈、读第三方文档时表现神勇,就放它去打头阵;如果在核心业务的常规迭代里,它总是产出难以接管的冗余代码,旧模型依然是更称手的工具。升级工具不需要成为整齐划一的团队表态。
开发者完全可以用一个最朴素的尺度拒绝跟风:如果交付同样的改动,新模型让我花了更多时间去审阅和接手,那它就不是一次划算的升级。
下次决定换模型之前,先记下它宣布做完之后,你还替它收拾了多久。