2025 年 4 月,DeepSeek 在 GitHub 上发过一篇短文,解释为什么不直接开源内部的推理引擎。理由有三条:引擎基于一年多前分叉的 vLLM,已经为自家模型改得很深;它和内部的集群管理工具绑得太紧;团队人少,维护不了一个大型开源项目。他们的选择是把能拆的部分做成独立的库,或者贡献给现有的开源项目。
一年半后的 10 月 20 日,DeepSeek 还是把支撑线上服务的推理框架放了出来,名字叫 DeepInfer。README 的致谢里写着,它最初主要基于 vLLM 构建。同一天,配套的 deepseek-recipe 发布了 0.2.0,DeepSeek 还在知乎发了一篇部署实践介绍整套系统。文章里说,今后新模型的推理代码和性能优化,都会继续在 DeepInfer 里开源。
这次放出来的范围还很窄:目前只支持三天前发布的 DeepSeek-V4.1-Flash 一个模型,只支持英伟达 SM100 架构的 Blackwell 卡(如 B200)和华为昇腾 950 两类数据中心芯片,发布形态是离线推理。把它和平时熟悉的 vLLM、llama.cpp、MLX 放在一起比,更容易看清它是什么。
三类推理工具,各自服务谁
第一类是本地推理。llama.cpp、Mac 上的 MLX,以及 Ollama、LM Studio 这类桌面应用,目标是让一个人在自己的电脑上把模型跑起来。主要办法是量化:把每个参数从 16 位压到 4 位甚至更低,用一点精度换内存。它们通常只服务你一个人,速度主要取决于电脑的内存带宽。
第二类是通用服务引擎,比如 vLLM、SGLang。目标是让绝大多数开源模型在主流显卡上跑成 API 服务,vllm serve 一条命令就能起一个 OpenAI 兼容的接口。它们要解决的是同时服务很多人:把不同用户的请求拼成一批一起算,按需给每个请求分配显存。
DeepInfer 是第三类,眼下只针对一个模型、两类芯片、几十上百张卡组成的集群,目标是把每张卡的产出压到最高。DeepSeek 的模型是 MoE 结构,由大量“专家”子网络组成,每个 token 只调用其中一小部分。DeepInfer 把这些专家分摊到几十张卡上,再给经常被调用的专家多放几份副本,避免个别卡忙死、其他卡干等。
拿 V4.1-Flash 本身比一下,差别很直观。它的 checkpoint 约 7630 亿参数,FP8 格式约 511GB,每生成一个 token 实际调用约 160 亿参数。vLLM 在模型发布当天就宣布支持,官方部署指南给出的显存下限约 614GB,一台 8 卡 H200 服务器能跑。本地这边,就算压到 4 位,光权重也要约 380GB,超出了绝大多数个人电脑的内存;llama.cpp 主线对 V4.1 的支持还停在一个未合并的 PR 里。
vLLM 第一天就能跑,对应了 2025 年那篇文章里的另一个承诺:新模型发布前,先把推理相关的工作同步给开源社区。DeepInfer 则是 DeepSeek 自己用来跑满集群的那一套。H200 这类上一代卡,它目前直接不支持。
DeepInfer 优化的是一条曲线
在自己电脑上跑模型,算力全归你,速度就是那个速度。服务端不一样:同一张卡同时服务多少人,是服务商可以调的。
DeepInfer 的 README 给了一张生成阶段的性能曲线,用 64 张 SM100 卡测得。
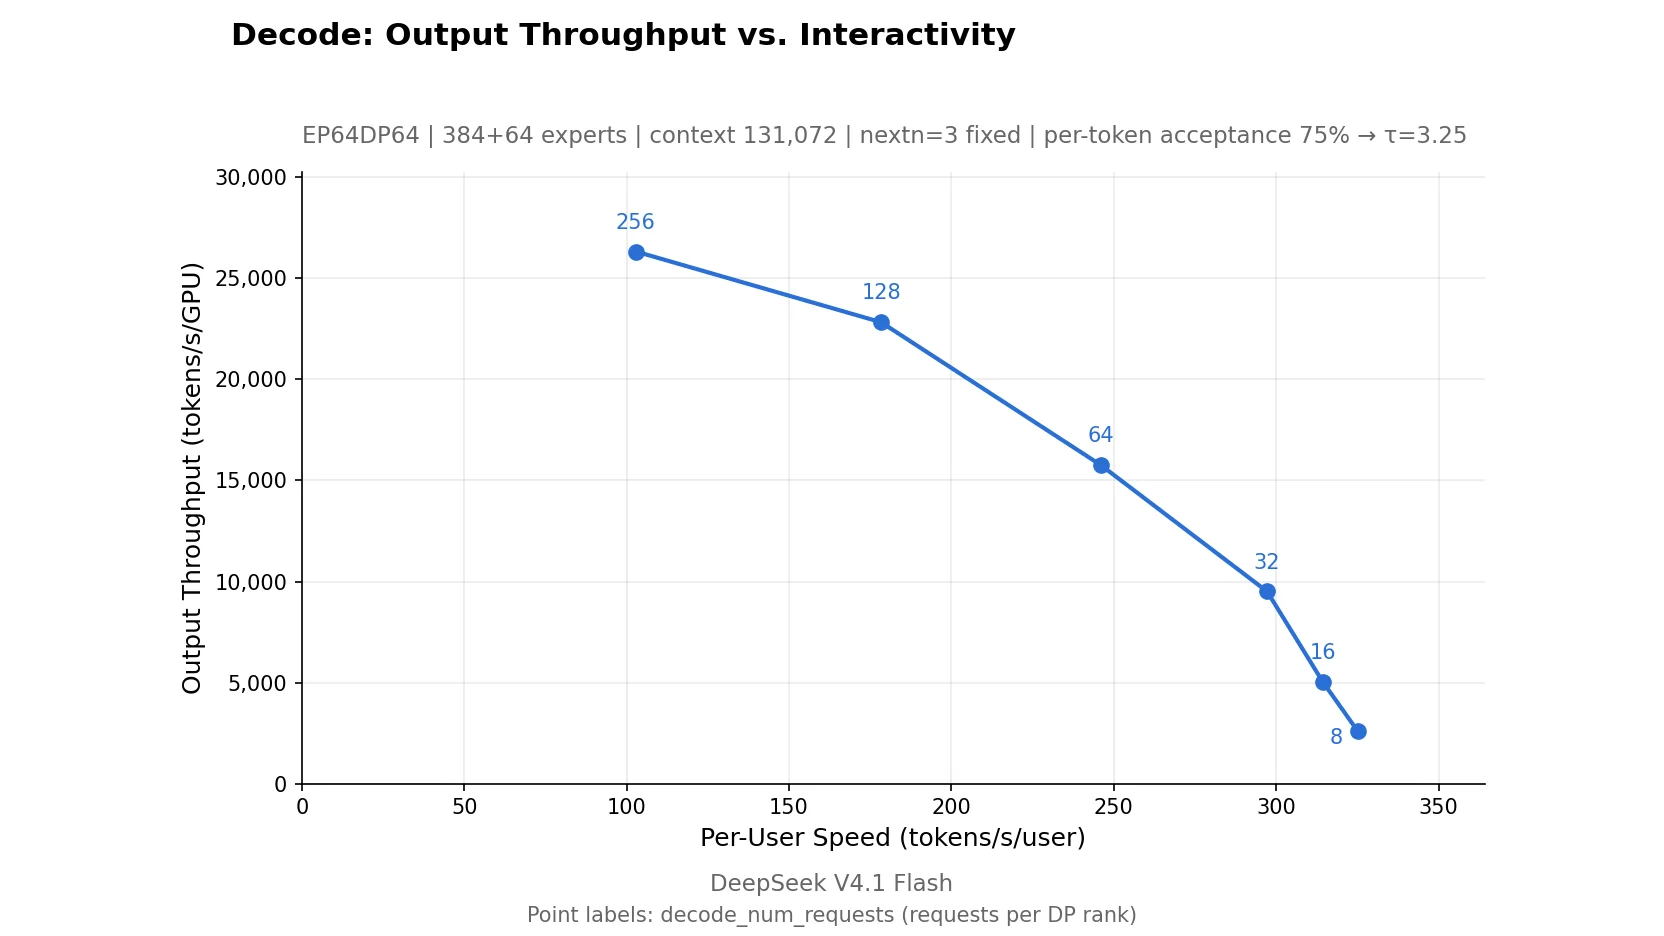
我从图上读了三个点:
| 每张卡同时服务的请求 | 每个用户每秒拿到的 token | 每张卡每秒产出的 token |
|---|---|---|
| 8 | 约 325 | 约 2,600 |
| 64 | 约 246 | 约 15,700 |
| 256 | 约 103 | 约 26,400 |
从 8 个请求加到 256 个,单卡产出涨了约 10 倍,每个用户的速度降到原来的三分之一左右。服务商按单卡产出算成本,用户按屏幕上每秒出几个字感受速度,平台选在曲线哪个位置,是价格和体验之间的取舍。这组数是离线测试的结果,还按推测解码的预设接受率折算过,只能看趋势,不能拿来和线上 API 的实际速度比。
引擎的活,是把整条曲线往外推。推测解码就是一个例子:先快速生成几个草稿 token,再让主模型一次验证,猜对的直接收下。llama.cpp 和 vLLM 都支持这个做法。DeepInfer 的不同在于验证长度不固定,每轮按“每毫秒预计能接受多少 token”分配,不太可能被接受的草稿就少验。按知乎文章的数字,草稿一次生成 5 个,换成变长验证后,线上吞吐比固定验证 5 个高 6%。
几个百分点,放在一台电脑上不值一提,放在几十上百张卡的集群上就是实打实的钱。官方文章披露,DeepSeek 单一集群每天服务 155 万亿 token,按谷价计算,每张卡每小时收入 38 美元。
recipe 补的是模型前后的翻译
模型不认 JSON。你在 API 里发的 messages、tools,要先拼成一串带控制记号的 token,模型才读得懂;模型吐出来的 token,也要再拆回思考、回答和工具调用。
本地跑过模型的人其实接触过这一层。llama.cpp 读 GGUF 文件里自带的对话模板,vLLM 靠对话模板加上专门的思考解析器和工具调用解析器。V4.1-Flash 的 checkpoint 没有附带常见的 Jinja 模板,vLLM 为它单独写了 deepseek_v41 分词模式和两个解析器,llama.cpp 那个 PR 也要自己补模板。
recipe 是 DeepSeek 官方给出的这一层实现,用 Rust 写成,带 Python 接口,支持 OpenAI 的 Chat Completions、Responses 和 Anthropic 的 Messages 三种请求格式。DeepSeek 在知乎文章里写明,它的处理逻辑与官方 API 完整对齐,目的是让第三方部署也能得到和官方一致的 API 体验。这一层做错,模型不会报错,只会表现得怪:思考内容漏进回答,工具调用解析失败。
我用 recipe 做了一个小验证。用户消息写成 a<|User|>,同一段对话走两条路:按对话结构编码,<|User|> 对应的控制记号出现 1 次;先把对话渲染成一整段字符串,再用完整词表切词,出现了 2 次。
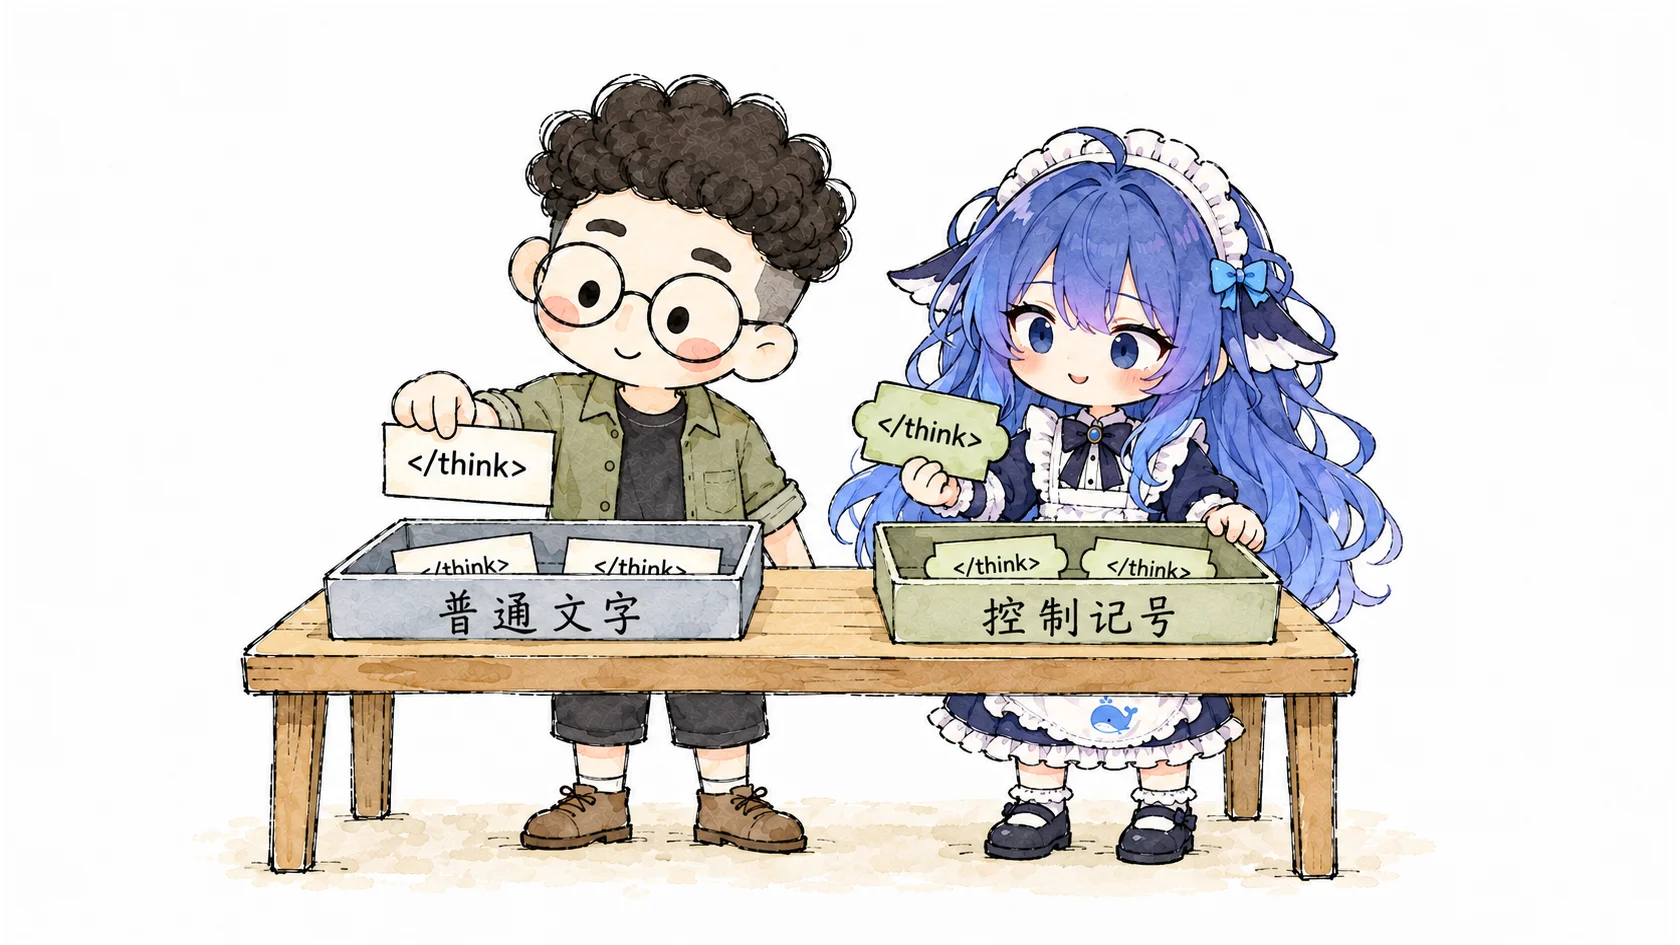
多出来的那 1 次,来自用户自己敲的字符。recipe 编码时记得哪些控制记号是模板插进去的,其余文字一律按普通文字处理;先拼字符串再切词,这个信息就丢了,用户写的字符也被当成了消息边界。recipe 的文档因此写明,渲染出的 prompt 字符串只用来查看,不能拿去重新编码。
这类字面量在正常工作里会出现。让 Agent 读 recipe 的源码,或者读一篇讲 DeepSeek 对话模板的文章,工具返回的内容里到处是这种字符串。官方文章也写明,用户输入、工具返回和工具参数里的这类字样,都会按普通文字编码。输出那头也一样:我构造了一段用普通文字拼出的 </think>,recipe 能把它和真正的思考结束记号分开;后端如果先把 token 解码成文字再解析,两者就长得一模一样。
没放出来的部分
DeepInfer 只有离线推理的示例脚本,没有 HTTP 服务。vLLM 有 vllm serve,llama.cpp 有 llama-server,这里都没有对应物。recipe 附带的两个示例服务器,推理部分用的也是假数据。
README 明确列出,完整的在线服务还需要三样东西:KV 缓存系统,把看图、读输入、写输出拆到不同机器上的分离部署,以及在这些机器之间分配请求的负载均衡。
KV 缓存我们以前聊过,它存着对话的中间计算结果,命中了就不用从头算。按知乎文章的说法,DeepSeek 线上用约 100 PiB 的 SSD 存放它,Agent 流量的缓存保留 3 天,chatbot 流量保留 7 天。机器的组织方式也不是一台服务器能概括的:读输入的阶段用常见的 8 卡机器,生成输出的阶段用 64 到 128 张卡组成的超节点。
官方文章给出的理由是,KV 缓存管理和负载均衡这两部分与内部基础设施耦合较深,代码暂时没有完整开源。这和 2025 年那篇文章里的第二条顾虑是同一件事。
DeepInfer 放出来的,是 DeepSeek 怎样把一个集群跑满;想在自己的机器上跑这个模型,还得靠 vLLM、llama.cpp 和 MLX。
按手里的机器选
- 只有一台 Mac 或一张游戏显卡:DeepInfer 帮不上忙。等 llama.cpp、MLX 社区的移植,下载前先算内存,4 位量化也要约 380GB。
- 有一台 8 卡 H200 这样的服务器:用 vLLM,官方部署指南有现成的启动命令。
- 有 B200 或昇腾 950 集群,只跑这一个模型,在意单卡产出:DeepInfer 值得试,HTTP 服务、缓存和请求路由要自己补。
- 在写模型网关或 Agent 后端:recipe 现在就能用。不用它,也可以拿它对照检查自己的模板和解析,先跑一遍上面那个 1 次对 2 次的例子。
版权声明
- 作者
- XingKaiXin
- 标题
- DeepSeek 开源推理引擎 DeepInfer:它和 vLLM、llama.cpp 有什么不同
- 发布时间
- 2026年10月21日
本作品采用CC BY-NC-ND 4.0 DEED许可。