
上周我维护一个自己用的命令行小工具,原本只是想加一个 --json 参数,方便在别的脚本里抓输出。
手头正开着终端里的 coding agent,我顺手敲了一行:“给 export 命令加个 —json 选项,格式对齐已有的字段。”
换成以前自己手写,这事极其简单:改两个文件,加个布尔值 flag,在打印的地方加个判断,把结构体序列化一下打出来,前后二十分钟收工。
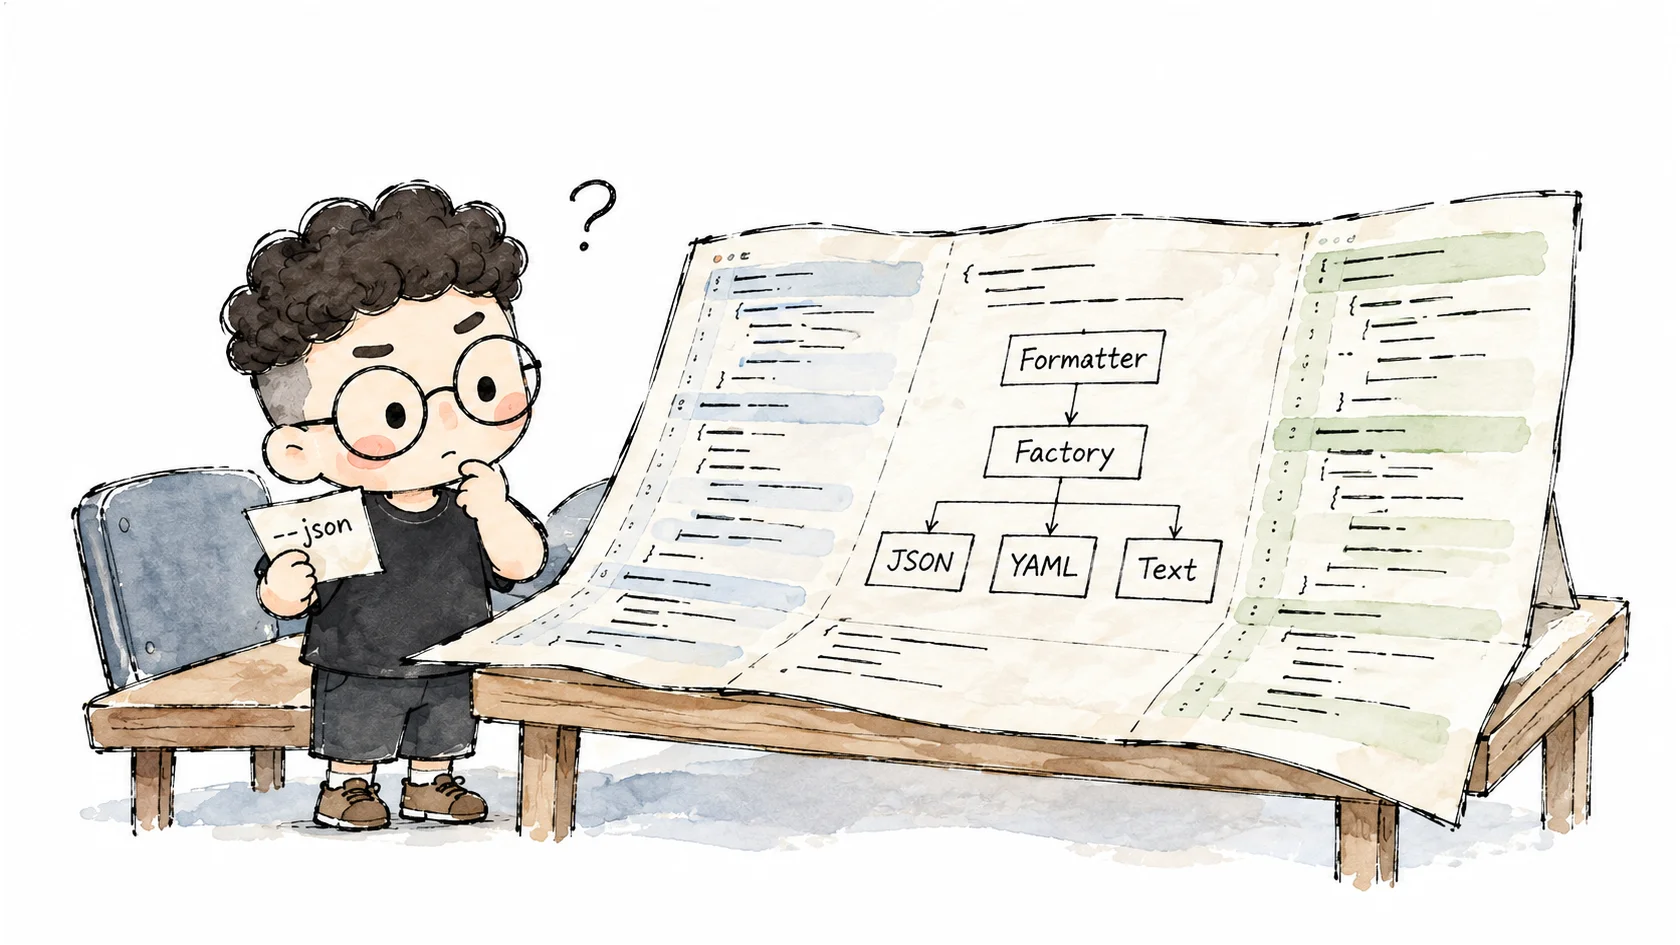
结果等我倒了杯水回来看屏幕,Agent 已经帮我把工程做全了。它觉得原来的输出逻辑不够模块化,自作主张抽了一套 Formatter 接口,下面顺手实现了 JSON、YAML 和纯文本三种格式化器,外加一个简单的工厂方法;顺带把三个相关模块的调用处全改了,新建了 5 个文件,改动了 11 处。
终端底下显示单测全部通过。
如果是刚开始用 AI 编程那会儿,我大概会觉得这工具简直太神了,要一给三。但我当时坐在屏幕前,看着那几百行整整齐齐的 diff,心里不仅没有轻松,反而是一阵强烈的烦躁:我今天根本没打算看 11 个文件的架构改动,以后更不想维护一套根本用不上的工厂类。
但我还是花了快半个小时去 review 那个 diff。因为它代码挑不出毛病,单测全绿,逻辑顺畅,你很难下狠心直接把它关掉。最后我还是点了合并。
第二天我就后悔了。一个原本 300 行脚本就能搞定的工具,复杂度莫名其妙翻了一倍。
以前决定一个功能做不做,实现的物理代价是一道硬闸门。
一个想法冒出来,只要稍微复杂一点,脑子里就会本能地算一笔账:这东西值得我花两天写、再花半天写测试和排错吗?只要答案有一点犹豫,这个想法就被随手扔掉了。
手写代码很累,调试更累。人类工程师天生带着一点懒惰,而这种懒惰在大部分时候是健康的——它帮整个系统挡掉了八成根本没必要的临时起意。
现在的 coding agent 把敲代码的边际成本直接砸平了。随便敲两句提示词,几分钟后就是一个像模像样的 PR。
那个替你砍需求的物理闸门,当场就碎了。
闸门碎了之后,最先涌进代码库的往往不是核心架构,全变成以前稍微算下账就会随手扔掉的边缘需求。这些需求看起来“反正不花钱”,不做好像亏了,于是它们全都大摇大摆地进了代码库。
放任 Agent 自己跑的时候,这种膨胀甚至会失控。
Armin Ronacher 曾经做过一个实验,让 agent 自己去跑一个 35 小时的无人值守软件工厂,目标是给 CPython 加上虚拟线程。中途烧了大约 10 亿 token,拉了 79 个 commit、7.5 万行代码,最终交付的有效产出是零。
翻看那份记录,最荒谬的细节是 agent 维护的任务清单:最开始是规规矩矩的 1、2、3、5、5a,跑到后面自己繁殖出了 8a、8a1、8b2c2b3,甚至还有一个叫做“8b2c2b2b checkpoint1”。
没有人在中间踩刹车,它就会拿着自己上一轮生成出来的半成品当成新的现实,接着给自己没完没了地派活。
许多人以为用上 Agent 之后最大的瓶颈是生成质量,但在真实场景里,最大的瓶颈是人类说“不”的心智带宽。
Ben Vinegar 在播客里聊过一段自己的感受。他说自己近期的实际产出根本没有提高,GitHub 上的提交活跃度甚至不如以前。底层的困境是他发现自己根本守不住想要的质量底线。
Armin 随手补了一句极准的洞察:当机器一直在提 PR 时,拒绝变得实质上更难了。
以前你的产出受限于你的手速。一天写出两个 PR,团队同事或者你自己花半小时审完,心智是可控的。现在 Agent 一天能在后台给你塞十个 PR。
但人类大脑消化代码的带宽,这一年里连 1% 都没有涨。
拒绝一份由 AI 写的代码,往往比自己写一遍更耗费精力。
你必须先看懂它背后的意图,核对它改动了哪些未声明的上下文,再在脑子里把这套逻辑推演一遍。这个理解过程耗费的认知资源,跟直接写一遍没有区别。更要命的是注意力被打碎的代价:Agent 生成改动是源源不断的,每隔半小时弹出一个完成通知,你手头正在思考的主干逻辑当场就被击穿了。
个人的手速被放大了,但所有人都在为别人随手生成的代码买单。
既然物理成本已经无法阻止代码膨胀,我们就得在工作流里人为补上几道刹车。
这几个月我自己踩过几次坑之后,把工作流做了强制调整。
开工前先回答一个难听的问题:“如果这个改动不做,明天谁会找我麻烦?”
以前我们习惯问“这个做起来要多久”,在 Agent 时代这个问题彻底失效了,因为答案永远是“五分钟”。现在我只问后果:是线上某个指标在跌,还是某个高频操作真的把我卡住了?如果回答不出来,纯粹只是觉得“顺手支持一下挺好”,立刻把光标移出对话框,一个字都不准发给 Agent。
其次,把随叫随到的交互改成离线批处理。
不要开着终端窗口盯着 Agent 一轮轮吐代码,更不要在它每提一个分支的时候就切过去审阅。那是在拿自己最贵的注意力去给廉价的算力陪跑。
我现在只在每天固定时间片里集中看一次代码。其余时间让它在单独的 worktree 或容器里折腾。如果在设定的时间里它做偏了,或者为了一个小功能顺手改了十几处不相干的文件,不要去 review,更不要试着在对话框里帮它纠错。
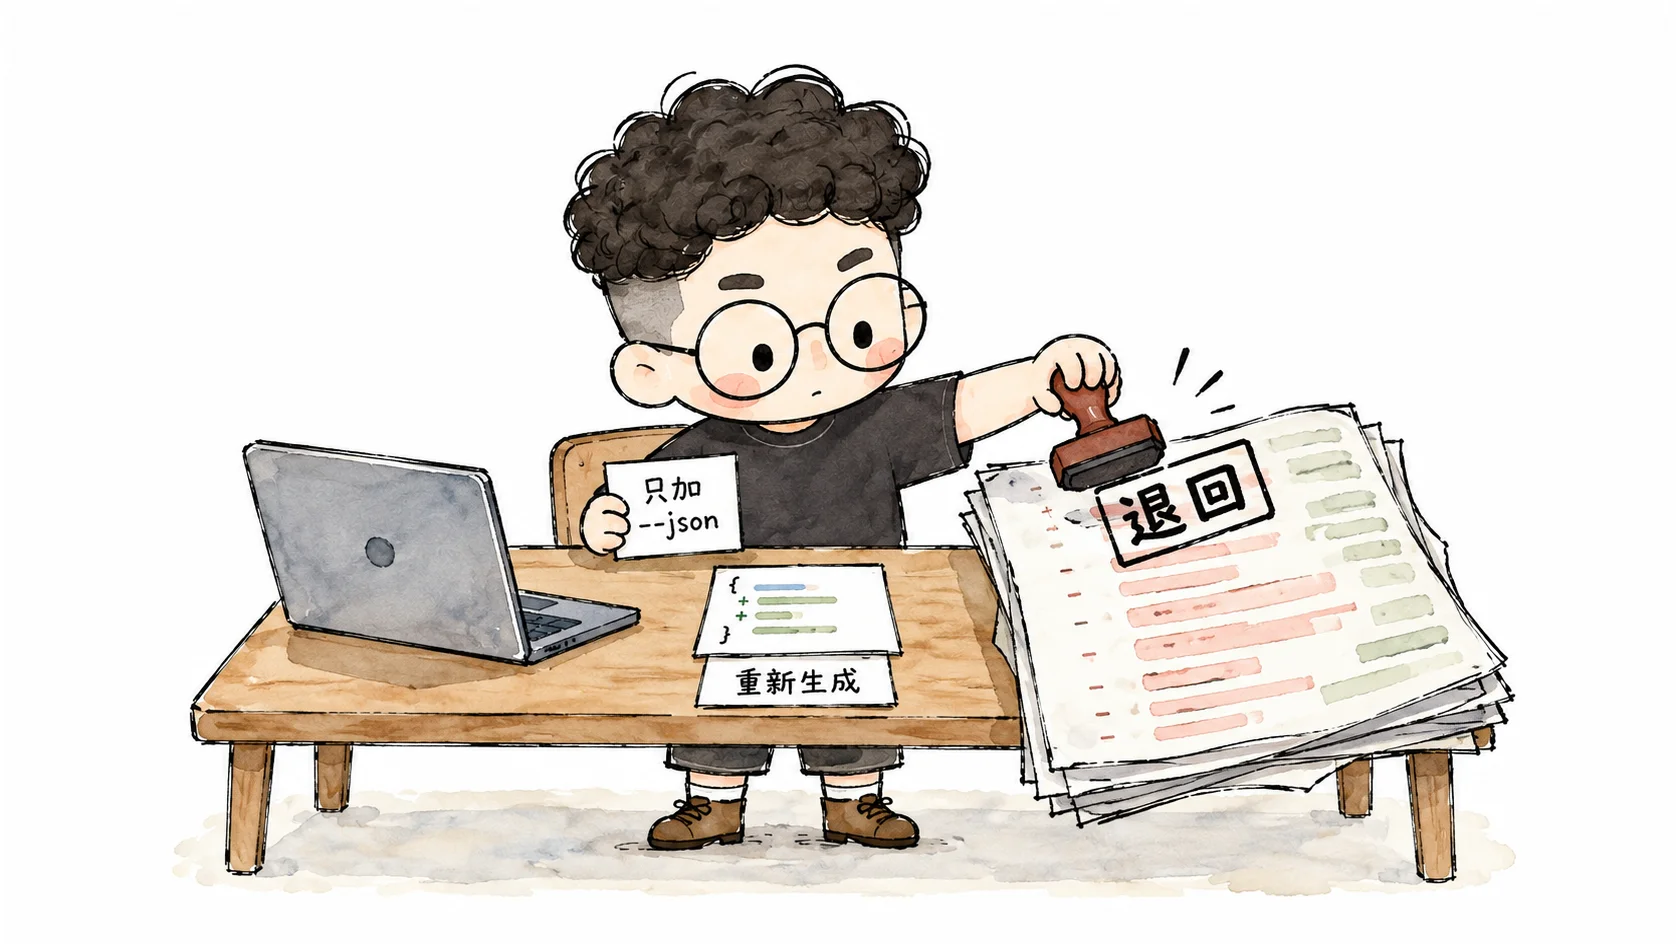
最管用也最需要克制心理惯性的动作,是直接按 git reset --hard。
看着一段排版工整、测试全绿的代码,很多人心里会有一种舍不得扔的贪念。总觉得既然都写出来了,留着总比删了好。
但软件工程里最残酷的常识是:代码不是资产,代码是负债。每一行躺在仓库里的代码,未来的每一天都在向你收取维护税。
只要 Agent 交付的内容超出了我最初规定的物理边界,哪怕它写得像教科书一样漂亮,我也一律不看不收,当场回滚。重写两句更严密的约束重新生成,花费的精力通常只有顺从它的思路去 review 的十分之一。
能在 AI 时代把代码库维持得轻便可用的人,靠的不是让模型写得多快。
真正拉开差距的,是在无限倾泻的代码面前,你敢把多少看起来挑不出毛病的东西直接丢进垃圾桶。