
上个月帮一个朋友看他们线上服务偶发卡死的问题。
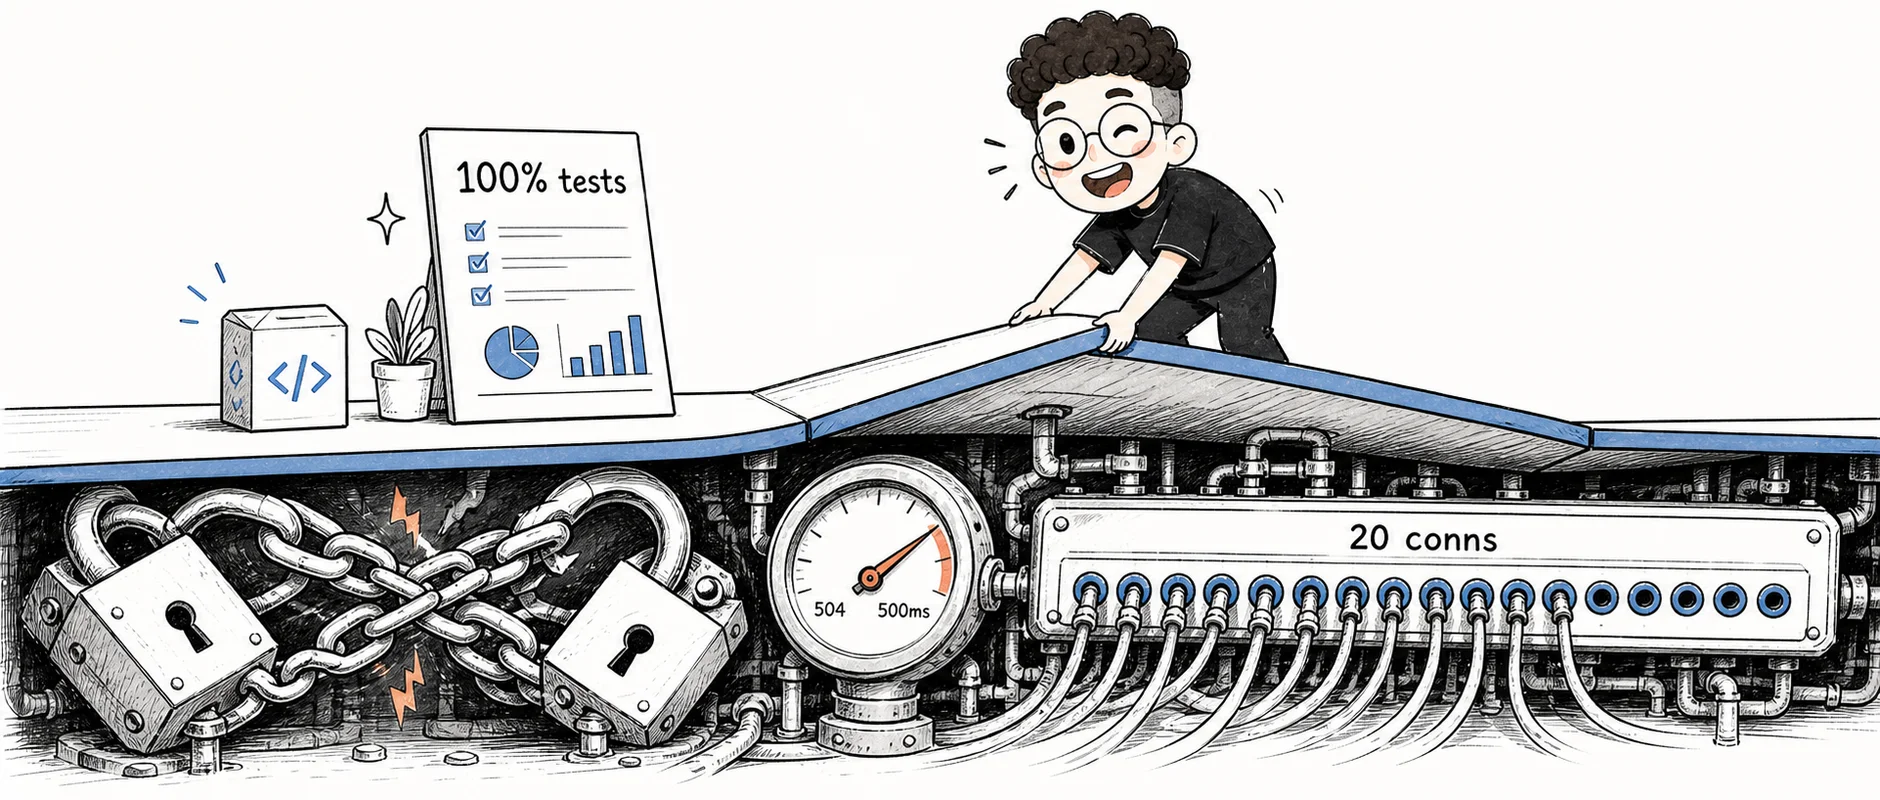
出问题的接口逻辑极其简单:用户支付成功后,核销一张优惠券,更新订单状态,然后发一条通知。这段代码是他们用 Agent 一键生成的,PR 里附带了八个单测,本地用 SQLite 跑得飞快,覆盖率 100%。
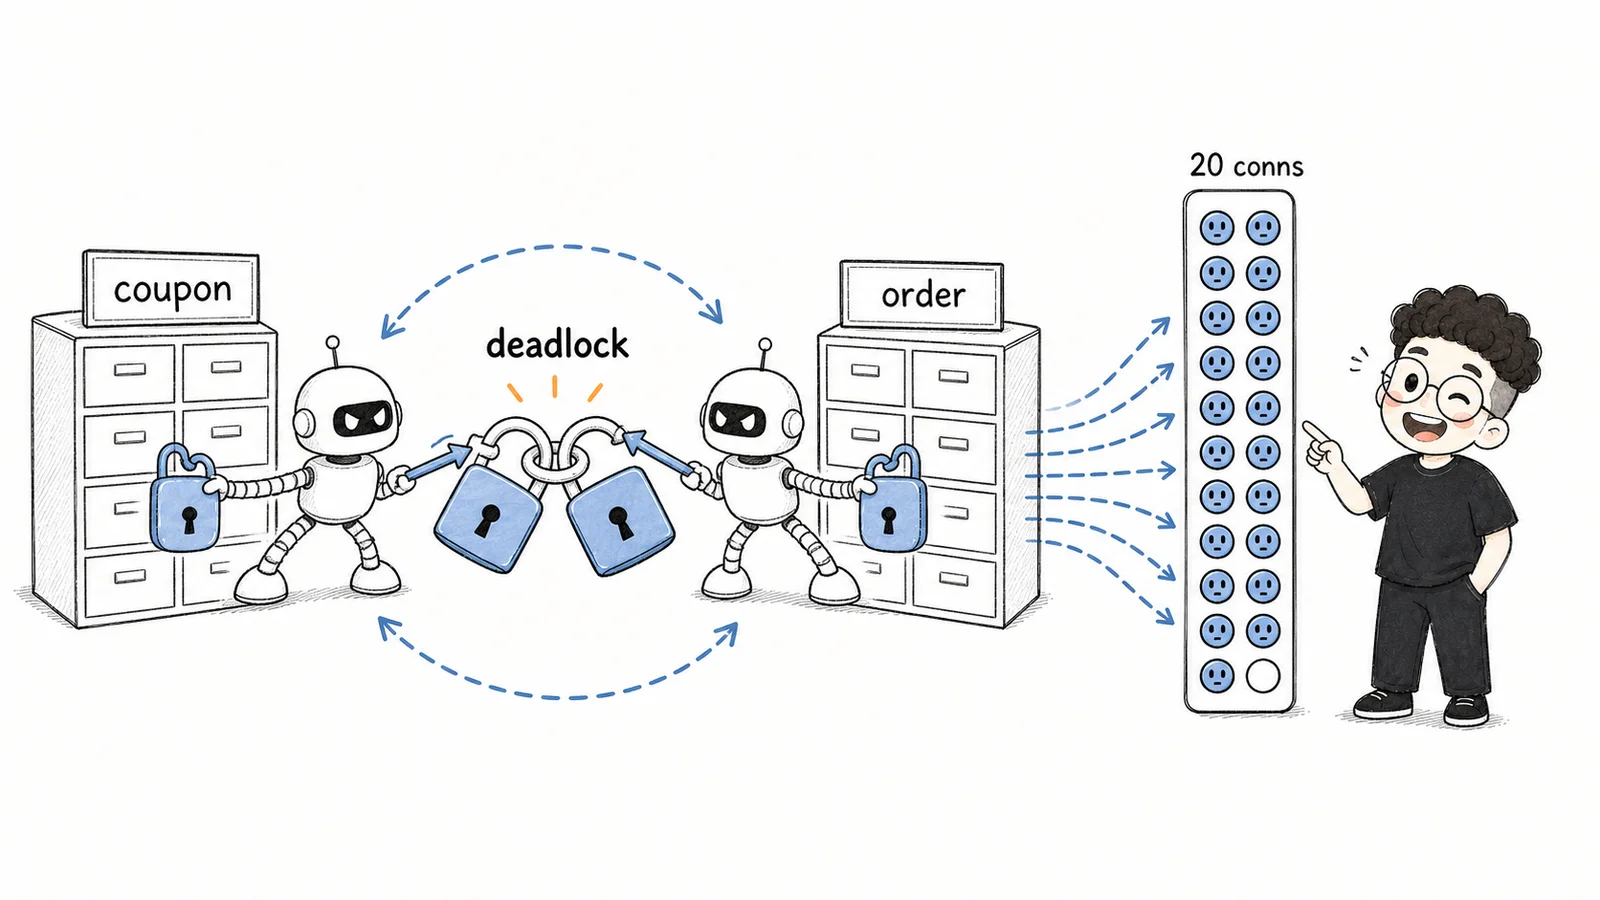
但在预发环境一压测,并发稍微上到三四百,整个服务就陷入死锁,数据库连接池瞬间被抽干。
排查进去才发现,Agent 生成的代码里,先查了用户券表加了排他锁,再去查订单状态;而另一个异步对账任务里的锁顺序刚好相反。不仅如此,网络超时重试被随手配了三次立即重试,一旦下游网关稍微抖一下,重试流量直接把底层的连接池彻底打死。
这几个月技术圈到处充斥着一种论调:“写代码从来不是难点,想清楚需求才难。”
仿佛敲键盘和写逻辑已经变成了随手可得的廉价体力活,未来的程序员只需要懂产品、懂业务,张嘴说两句需求,剩下的丢给 AI 就大功告成了。
这种话听起来很轻巧,但只要在线上经历过几次真实故障,就会发现这完全是不切实际的幻觉。
需求是愿望,代码是对物理世界的严密计算
很多人以为“想清楚需求”是最高阶的能力,因为他们把需求理解成了一句大白话: “做一个用户支付超时自动退款、支持高并发秒杀的商城系统。”
说出这句话确实只要两秒钟,但在工程实现上,这句话里面每一个词都在向底层的物理硬件索要代价:
- 下游支付网关返回 504 超时的时候,这笔钱到底扣没扣?本地状态机停在哪个中间态?
- 消息队列重放一条半小时前的扣款事件,你的幂等键是挂在 Redis 还是靠数据库唯一索引拦截?
- 在只有 20 个连接的 PgBouncer 连接池后面,一个长事务卡住 500 毫秒,会不会把整个服务的健康检查探针直接拖超时导致容器被 Kubelet 连环重启?
这些藏在状态机、并发竞争、异常回滚和连接池配置里的具体细节,才是一个软件系统真正活着的部分。
把自然语言意图翻译成一段看似工整的语法,AI 确实几秒钟就能搞定。
但 AI 根本不知道你在生产环境用的是什么版本的 PostgreSQL,不知道你的网络在跨可用区调用时会有 15ms 的抖动,更不知道你配置的垃圾回收器在短对象激增时会触发几百毫秒的 Stop-the-World。
把这些极其苛刻的物理约束,严丝合缝地固化进每一行代码和异常处理里,这从来就不是廉价的体力劳动,而是整个研发链路里最硬的一道坎。
以为省了事,其实全转成了排错的脏活
打字和搬运样板代码的门槛确实归零了。
以前写一个带重试的 HTTP 客户端,你得查文档、配退避算法、处理连接复用,手写半小时;现在 Agent 敲个回车就能吐出来。
但这并没有让写出好代码这件事变容易,反而把问题变得更隐蔽了。
以前手写代码,每一行从你脑子里流过去,你会下意识考虑这个指针会不会为空、这个 Map 在多线程下有没有加锁保护。
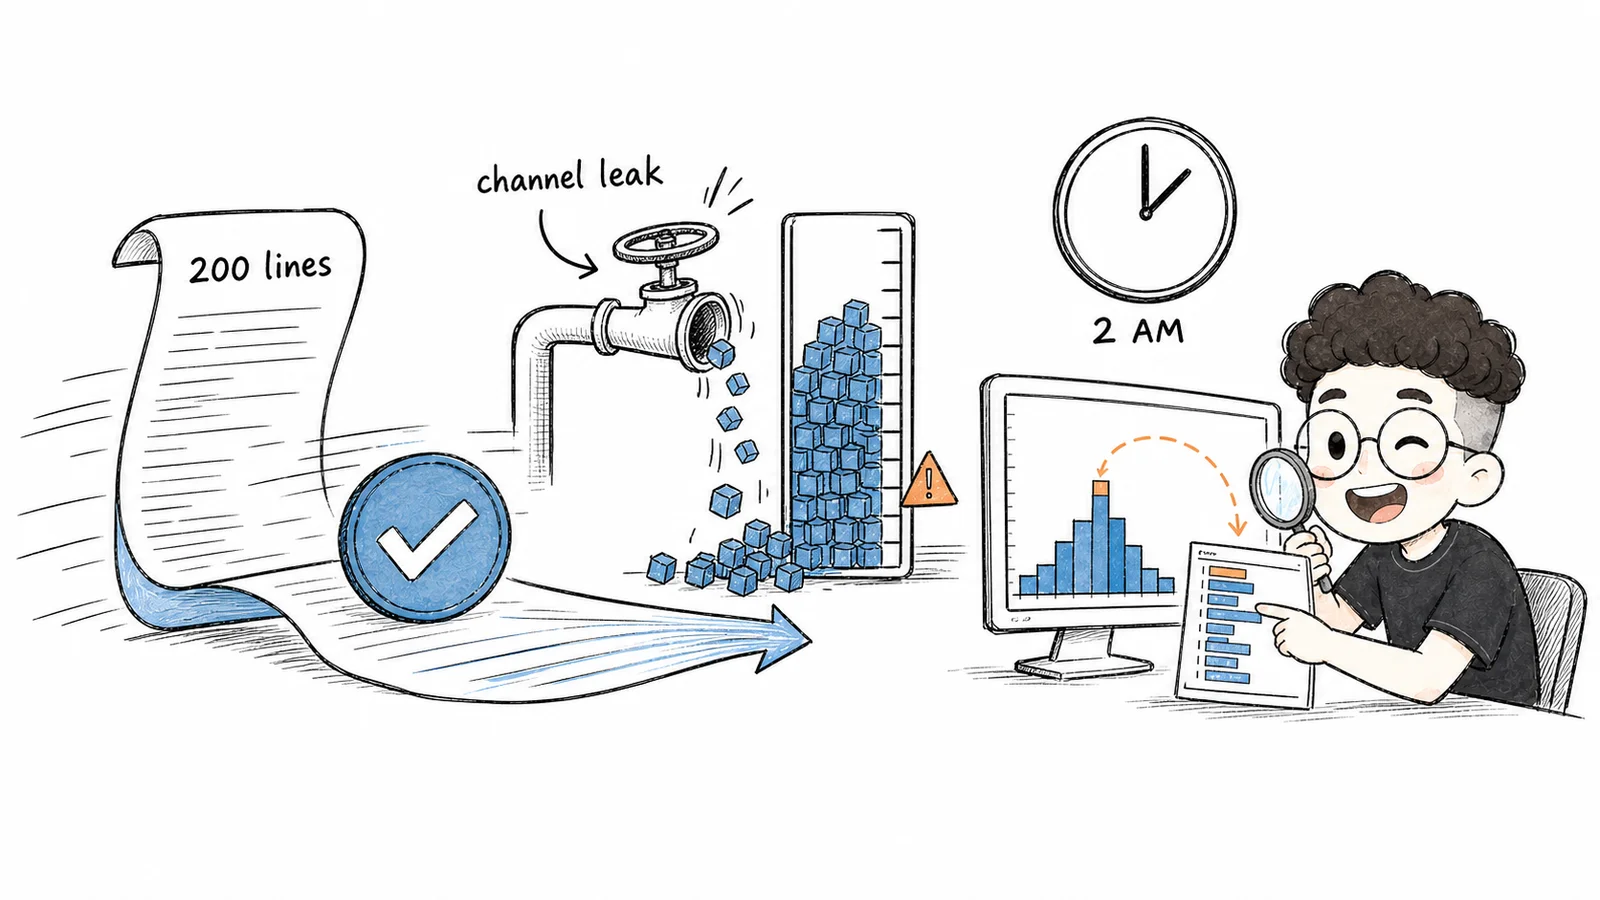
现在 Agent 一次性倾倒出两百行语法毫无破绽的代码,单测全绿,你扫了一眼觉得挺工整就合进了主干。直到某个周末凌晨两点,监控大盘突然报警,你在十几个微服务的调用链路里翻找日志,才发现某个隐藏在第三方 SDK 内部的 channel 没有关闭,正在一点一点把内存吃光。
这时候,那个把需求挂在嘴边、宣称“只要想清楚逻辑就行”的人往往束手无策。
能把系统救回来的,依然是那个知道 Linux 进程状态、能看懂 CPU Flame Graph、能在 GDB 或堆栈 Dump 里面定位到死锁内存地址的工程师。
谁在真正兜底
如果写代码真的不难,过去几十年计算机行业就不会为并发模型、内存安全、事务隔离级别写出几千篇论文;如果写代码只是简单的意图翻译,全世界的生产系统就不会有每天都在复盘的事故报告。
AI 抹平的,只是按键打字和背诵 API 的机械成本。
它把写代码这门手艺里的杂质洗掉了,但留下的那部分——对系统边界的洞察、对异常路径的防守、对真实物理资源的敬畏——反而变得前所未有的昂贵。
别被那些轻飘飘的断言带偏了。
能把宏大愿景说得动听的人到处都是;但当系统遭遇真实流量拷打时,能守住底线、让每一行代码在物理世界里站得住脚的,永远是那个真正清楚指令如何跑在机器里的人。