
你在 APM 链路监控里抓过大模型接口的耗时,大概都看过这种让人血压升高的调用栈。
一段客诉文本扔进接口,下游代码实际上只等待一个布尔值:用户到底是不是要退款。
为了拿这一个字段,通常的做法是调 GPT-4o 挂个 Structured Outputs。整趟往返跑完,耗时 1.8 秒。
把这 1.8 秒的 trace 展开看更绝望:模型读取整段输入的 Prefill 阶段只用了 220 毫秒。剩下的 1.6 秒,显卡纯粹在自回归地逐字打字:左大括号、换行、四个空格缩进、引号、is_refund、冒号、空格、true、最后补一个右大括号。
这就好比你在路口问个路,对方必须把一本字典从头背到尾,背到“向左转”三个字才算完。几百亿参数的模型在显卡上空转了几十步前向计算,纯粹是在给下游拼凑符合语法的 JSON 语法糖。
并发稍微冲高一点,整个网关的长尾延迟全被这些毫无业务价值的花括号堵死了。
换小模型,也救不了自回归打字机
有人肯定会说:换个 1B、3B 的轻量开源模型放本地跑不就结了?
快不了多少。
在大模型出来之前,没人受这个罪。各家都在业务线上养专有小模型,客服做意图识别搞个几兆大小的分类头,风控做审核搞个专有小 BERT。这套东西后来被扔掉,纯粹是因为标注语料和反复微调太折腾人,而且一旦遇到用户的错别字和网络黑话,分类准确率掉得没法看。通用大模型零样本就能看懂各种口语暗语,大家才蜂拥切到了大模型。
但生成式模型的物理机制是焊死的:预测一个 Token,拼进显存,再预测下一个。
哪怕在接口层用了基于有限状态机(FSM)的严格 JSON 约束,底层做的事情也仅仅是在每一步解码时把非法的 Token 概率掩蔽掉。该跑的前向计算步数,一步都没少。
要是同一个请求里既要问部门、又要问退款、还要对紧急程度打个分,在同一个 Prompt 里塞三个字段,解码耗时直接翻三倍;拆成多次请求去调,网络往返和前向读取又在成倍空耗。
下游需要的只是一道选择题的离散结果,但生成式模型给出的却是一篇必须按顺序写完的说明文。
亲自上手试 Jev:把打字机砍掉,只留答题卡
TypeSafe 最近推的 Jev,号称比大模型快 193 倍、便宜 444 倍。
我顺着它的文档去试了一下它的 API。
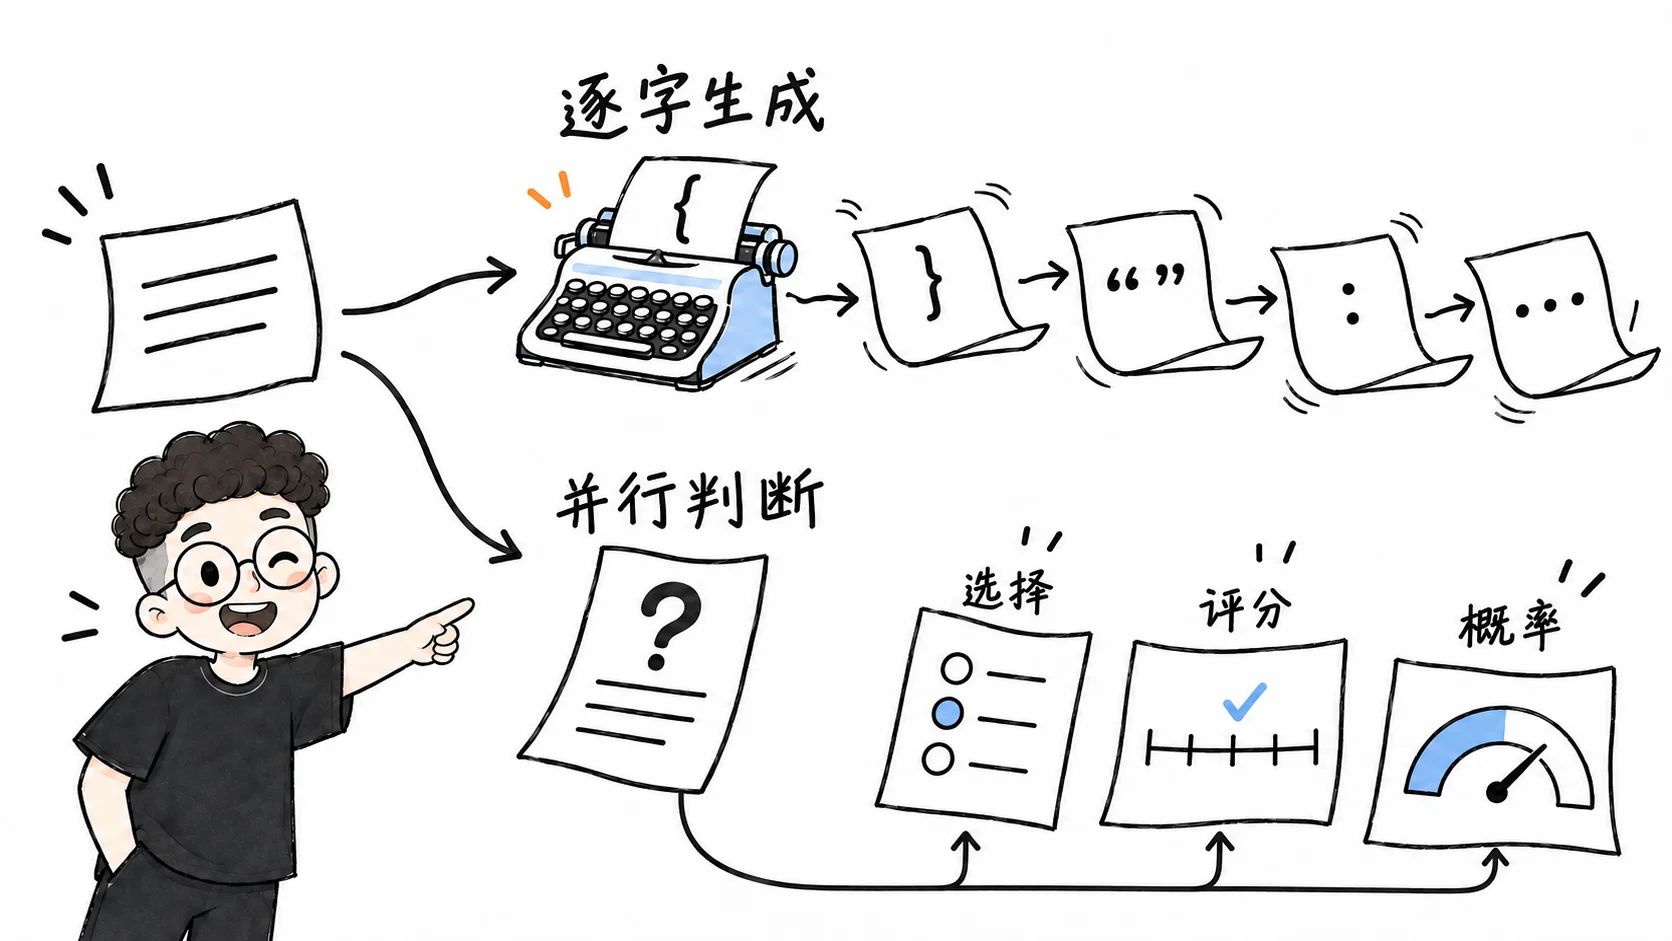
它干的事情很纯粹:保留 Prompt 的提问方式,但把自回归生成能力彻底阉割了。
接口定义很简单,把你要审视的文本塞进 state,底下挂一个 questions 数组。它支持三种判断类型:
choice:给几个选项做单选(最多 255 个);score:给几个离散等级算加权连续分;noul:问是非题,直接返一个 0 到 1 的概率。
我随手写了个脚本,把一段典型的退款留言丢进去,一口气挂了 5 个问题(判断部门、是不是退款、情绪激烈程度、是否威胁投诉、是否涉及重复扣款)。
回车敲下去,终端打出来的响应时间确实有点吓人:不到 80 毫秒。
拿回来的结果里没有任何 JSON 字符串解析的过程,直接就是一个带字段的原始对象,概率和选中项清清楚楚。因为它底层不走逐字解码,面对这 5 个问题是直接并行采样算的,一次前向传播全部搞定。
但就在我觉得这玩意能解决问题的时候,我喂了它一条稍微拐了点弯的真实客诉:
“你们这客服处理速度真是神了,催了三次没人理。不用退了,直接 12315 见吧。”
猜猜它返回了什么?
is_refund 的概率直接跌到了 0.08。它极其自信地判定:用户没有退款诉求。
这就是受限输出最致命的盲区。
它能从物理机制上保证绝不吐出选项之外的乱码,绝不会在网络传输里把 JSON 格式写挂(这一点确实省心,下游一行防御性正则都不用写)。
但这只能管住它的嘴,管不住它的脑子。
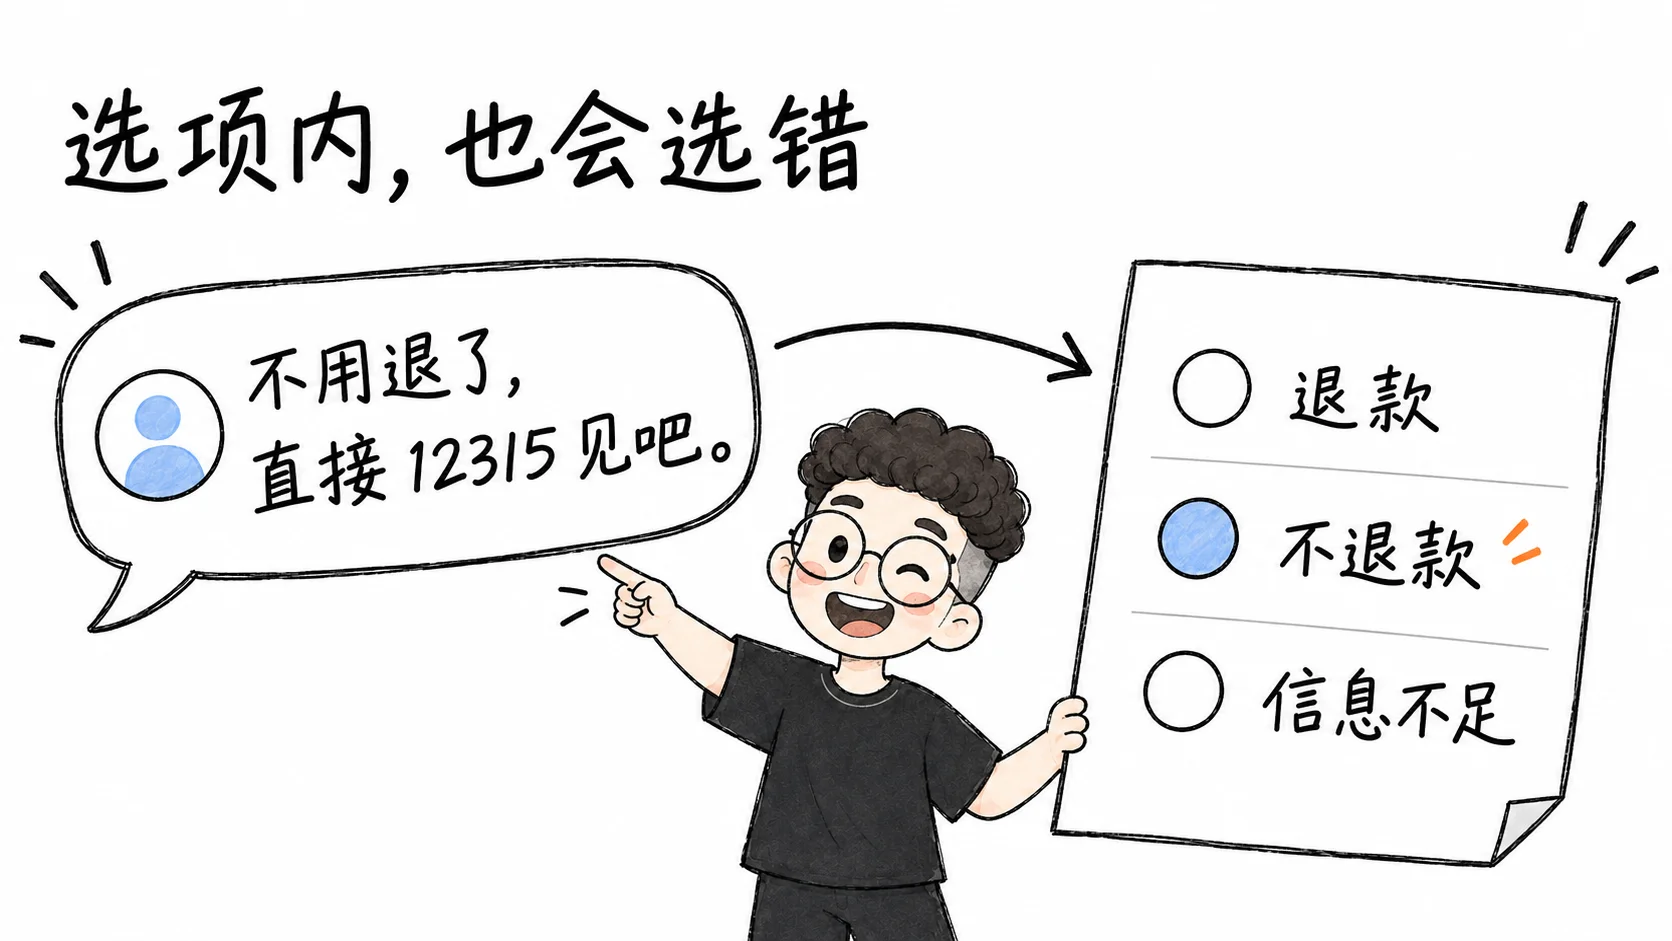
它底子依然是个统计概率模型。面对反讽、倒装句或者稍微带点情绪的语境,它完全可能极度自信地选出一个南辕北辙的答案。如果你的选项列表里漏掉了“以上皆非”或者“信息不足”,它更是只能硬着头皮在错误的集合里挑一个自以为最像的。
这时候再看它标榜的 RLCD(概率校准),就明白为什么官方把这东西当成核心卖点了。如果一个模型给出的 0.8 概率不能在统计上对应 80% 的真实发生率,下游系统根本不敢做分级放行——只有概率经过校准,你才敢在代码里写:0.95 以上自动过,0.4 到 0.7 之间扔进人工审核队列。
官方吹的两百倍提速,水分有多大?
回过头来看官方宣传的“快 193.6 倍、便宜 444.6 倍”。
去翻翻它公开在 GitHub 和评测站点(evals.typesafe.ai)上的测试脚本,就会发现这个对照组有多流氓。
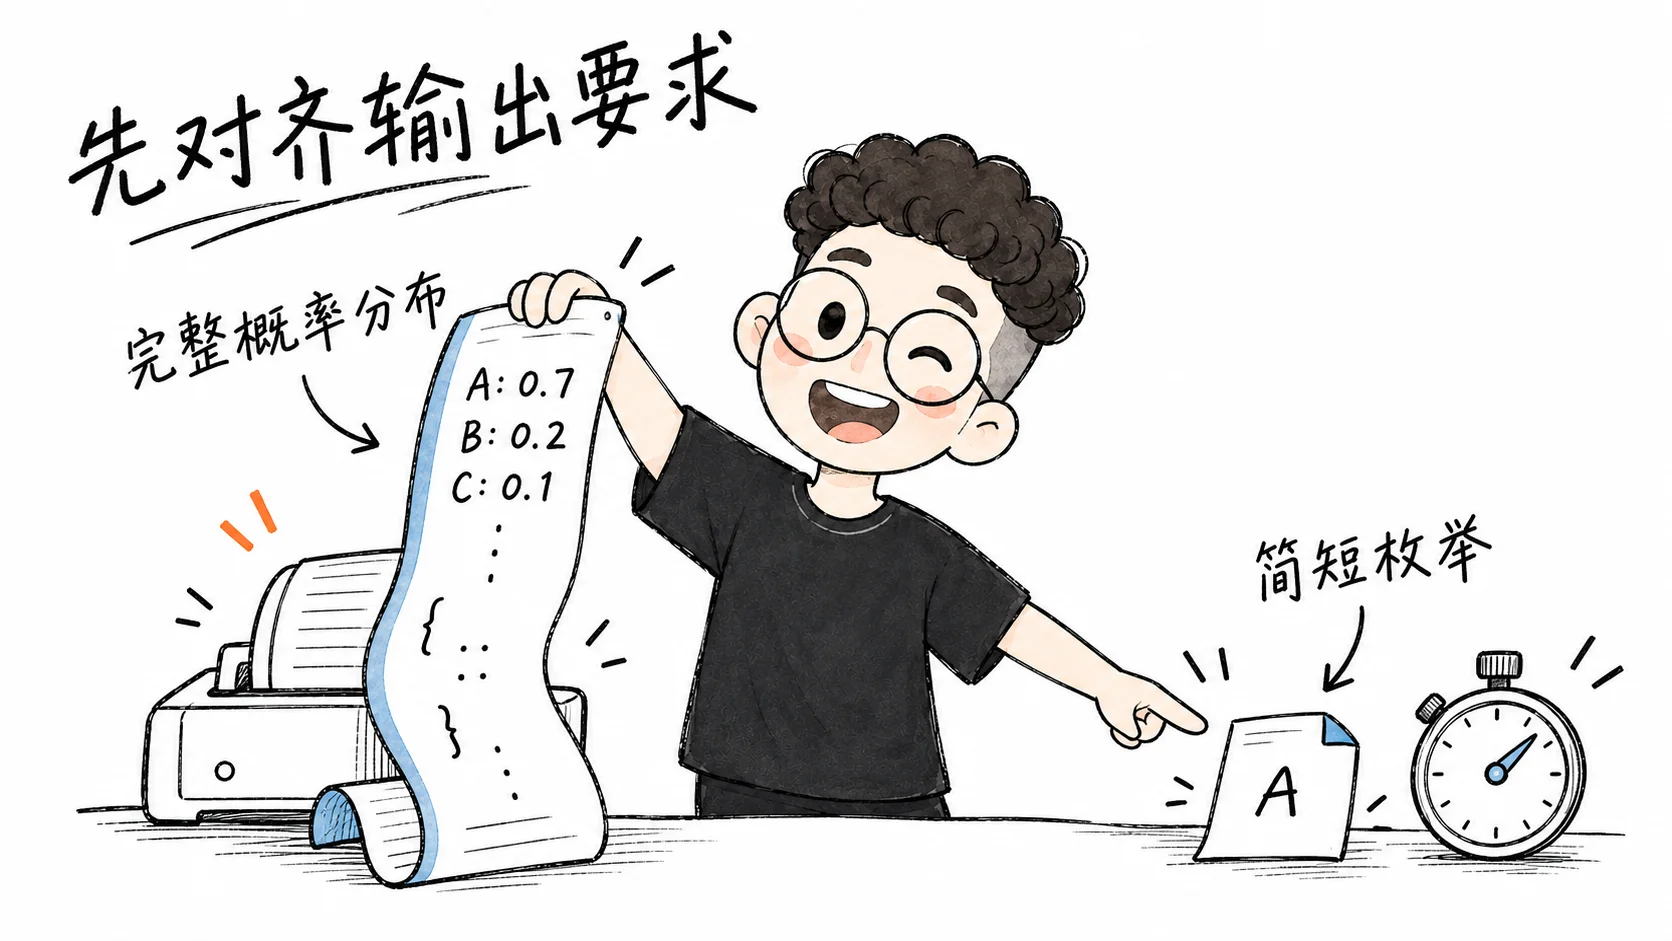
它抓来当对照组的通用大模型,被强行要求输出与 Jev 兼容的完整结构化概率分布。
大模型为了把每一个候选选项的概率值都写成浮点数字符串,在 Decode 阶段吭哧吭哧吐了几百个 Token;Jev 单次前向算完直接交卷。用这种方式比出来的近两百倍差距,只能证明逼大模型自回归打印浮点数蠢得要命,并不代表真实业务里真能快两百倍。真在业务里跑,要是只让大模型输出一个简短枚举,差距根本拉不开这么夸张。
Every 的 Mike Taylor 之前测过一组数据:对 37 篇文档并发提 21 个问题(累计 777 项判断),Jev 跑完花了 0.7 秒,账单折算约 0.0025 美元。但在另一组针对 12 段合成文本的写作缺陷排查里,面对预置的 7 个隐蔽缺陷,Jev 检出了 6 个,漏掉了 1 个,而作为对照的高推理大模型全找了出来。
快是真快,便宜也是真便宜,但遇到刁钻的边缘细节,它的漏判率是实打实存在的。
选型冷水:什么时候该用它?
而且有一点必须泼盆冷水:Jev 目前压根没开源,也没发任何论文披露底层的网络拓扑。
官方把它包装成“System One 决策模型”,听着挺像认知心理学的高大上概念,但说白了,它目前就是一个按每十亿 Token 收 42 刀(百万 Token 0.042 刀)的闭源托管 API。在官方正式公开技术实现之前,别轻易把它脑补成什么颠覆 Transformer 的神物。
如果你的系统里刚好有这几类需求,换成这种专用决策机制收益很明确: 智能家居网关里毫秒级解析目标房间与设备枚举、RAG 向量检索后快速给候选段落打分并筛掉提示注入、或者在 Agent 调高危工具前对入参枚举做快速断言。
这些地方要的只是几十毫秒内的离散状态拦截,让生成式大模型在前面逐字自回归吐 JSON 纯粹是在浪费吞吐。
但只要任务涉及起草一段有温度的长文回复、需要复杂的链式推理、或者需要提取用户随口说的非标准实体,它完全无能为力。
做系统设计没必要什么都指望通用大模型。分清你的接口到底是要一段自由文本,还是要一个跳转分支。把文本生成留给大模型,把条件分支还给纯粹的决策机制,整个系统的链路才能真正落回让人省心的区间。