
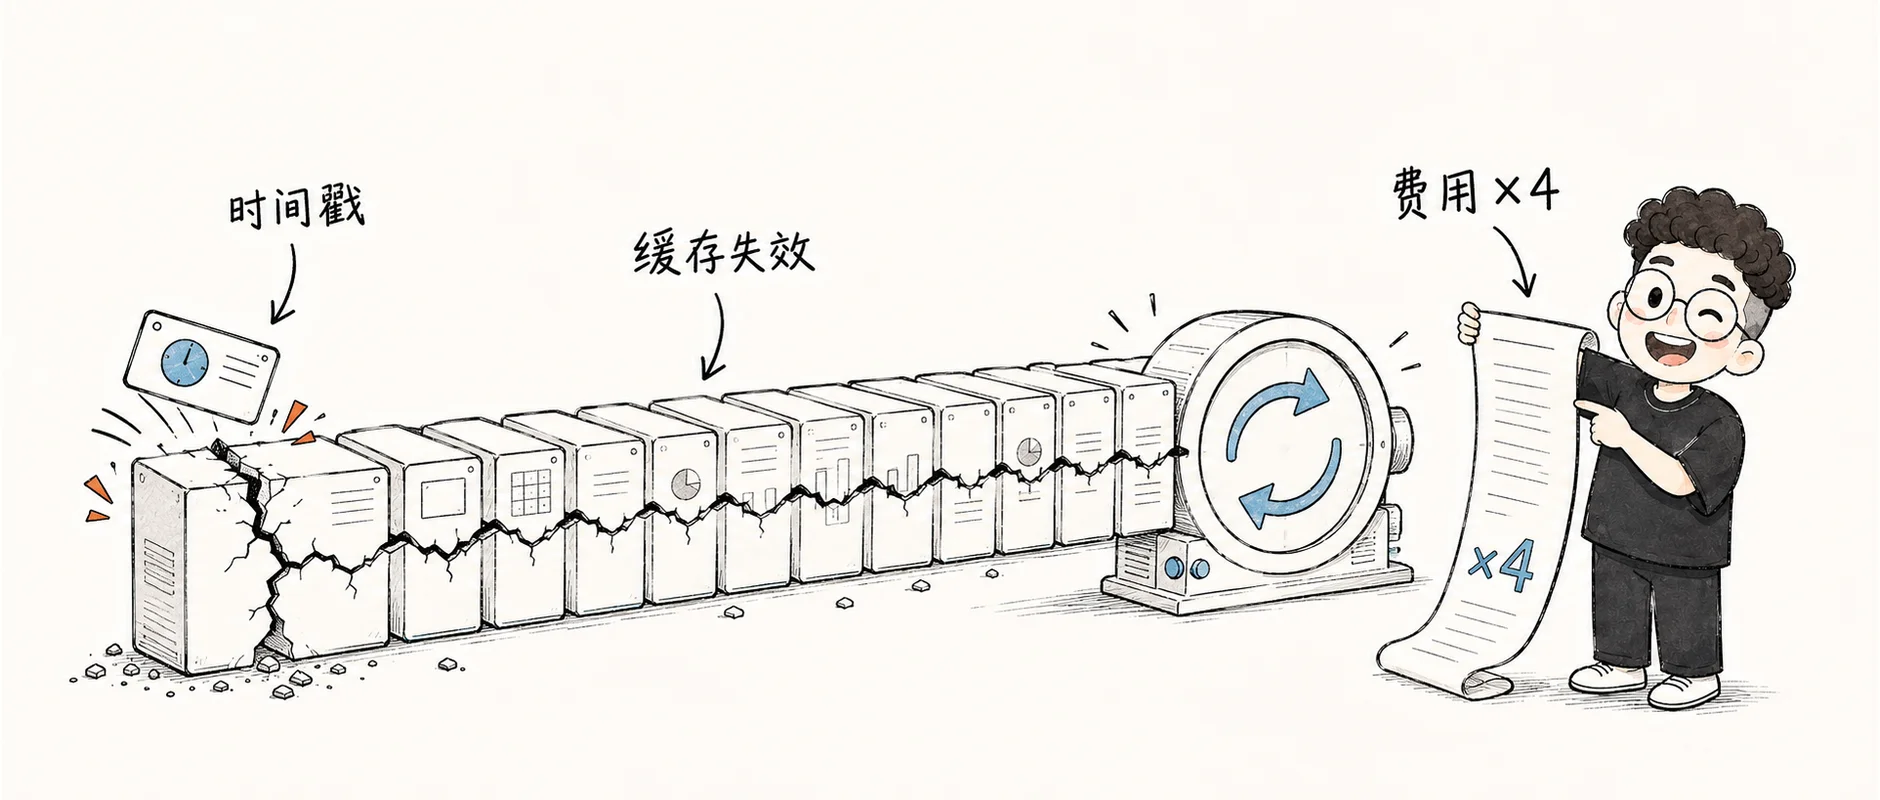
上个月帮一个做内部 Coding Agent 的团队排查性能问题。
他们的工程师跑来诉苦:会话刚开始两三轮还好,到了第十轮之后,Agent 每次回复都要转圈五六秒。月末拉出账单一看,输入 Token 的费用比预期高出整整四倍。
我让他们把发给大模型的原始请求日志导出来看了一眼。
System Prompt 写得很规整,工具定义也很标准。但在提示词最开头,赫然贴着一行代码:
const systemPrompt = `你是一个资深编程助手...
当前工作目录: ${cwd}
当前系统时间: ${new Date().toLocaleString()}`;
就为了让模型“感知当前时间”,随手加上了这一行时间戳。
这导致 Agent 每一轮发出的请求,在第 150 个 Token 处都会发生字符级的微小变动。这个变动带来的代价是:推理引擎把前面辛苦积累的几万个 Token 的缓存全部当成废纸扔掉,每一轮对话都从头做全量计算。
在 GPU 显存里,支撑 Agent 极速响应与低成本的关键,完全取决于你能否守住那条极其脆弱的前缀缓存(Prompt Cache)。
因果注意力的物理法则:改一个字节,后面全废
大模型处理输入时包含两个阶段:Prefill 阶段(读取所有输入 Token 并计算 Key 和 Value 张量)和 Decode 阶段(逐个生成新 Token 并复用算好的矩阵)。这部分保存在显存里的张量就是 KV Cache。
现代推理框架(vLLM、SGLang)与模型服务商普遍支持了跨请求前缀缓存:若新请求的前缀序列与上一轮完全一致,推理引擎可直接复用显存里已计算的 KV 状态,只对新追加的内容做增量计算。
这能把首字延迟降低 80% 以上,并带来高达 90% 的输入成本折扣。
但这套机制有一条不可逾越的物理红线:前缀精确匹配(Prefix Exact Match)。
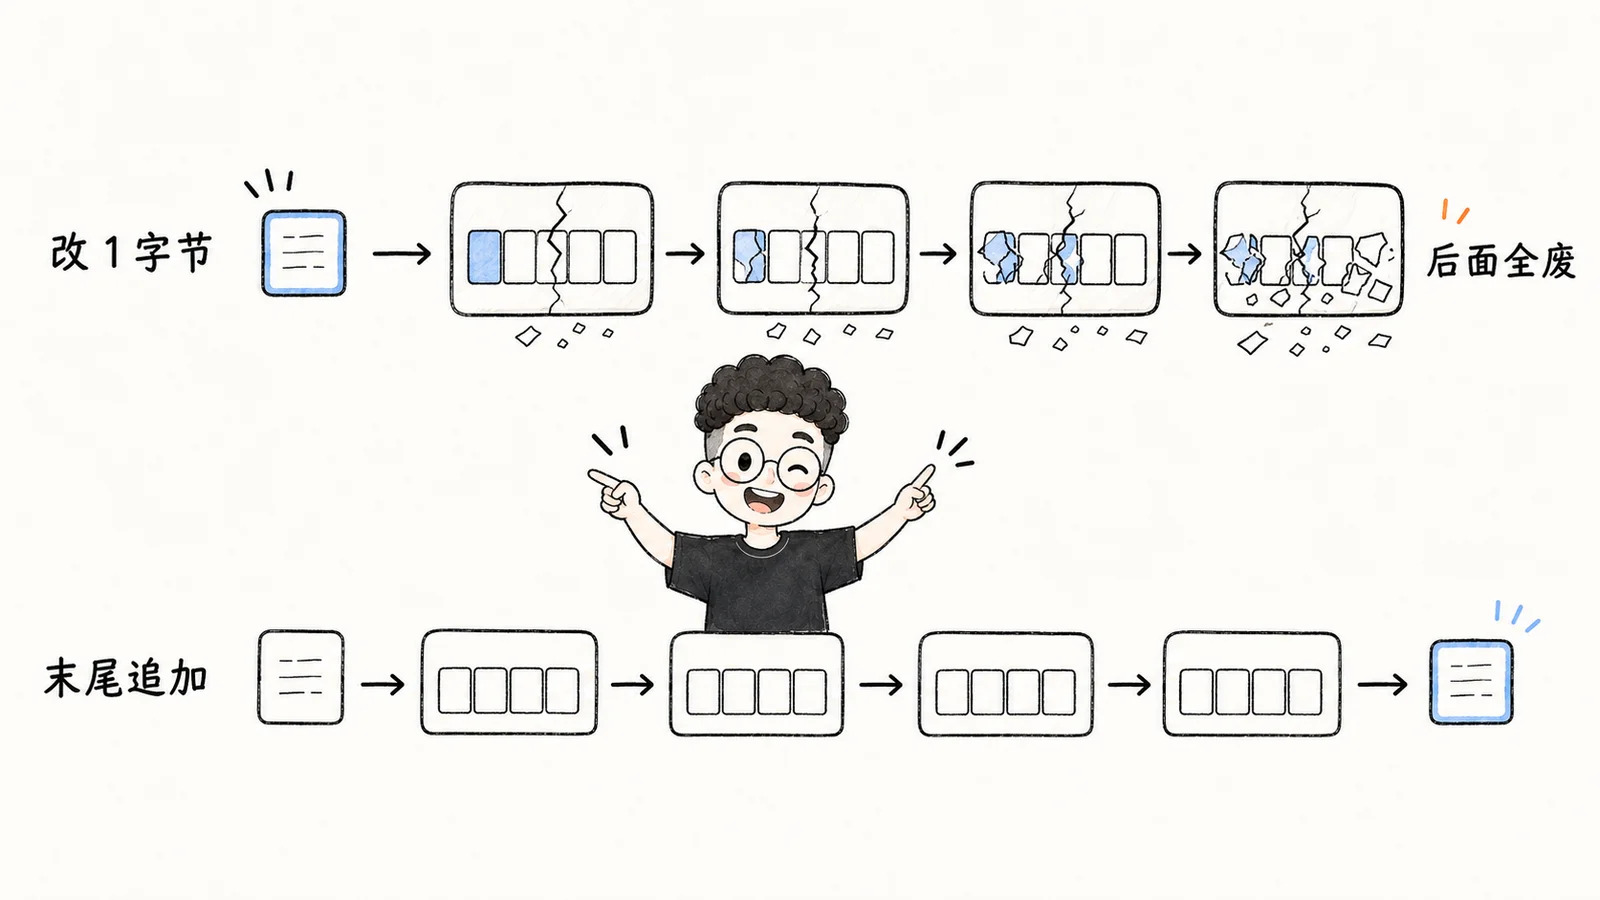
在自回归注意力机制下,计算当前位置的 Token 时,必须综合其前序所有 Token 的计算状态。这意味着:只要某个位置的前缀发生变动,该断点之后的所有计算状态都会发生雪崩式偏移。
缓存只认字节序列,而且是从第 0 个 Token 逐字对账。一旦在开头改了一个字符,后面几万个 Token 就算一字不差,也必须全量重算。
反过来,因果注意力的单向依赖也带来了一个推论:末尾追加是零额外重算开销的。新追加的内容绝不会回溯污染前面已缓存的状态。
写 Harness 时最隐蔽的 4 个“缓存杀手”
业务层看似合理的操作,放到推理引擎端,每一步都在让前缀缓存失效。
1. 在静态前缀里塞动态变量
开头提到的系统时间戳、随机生成的 Session ID、或是频繁跳动的 Git 分支名均属此类。
如果你把时间写在 System Prompt 顶部,每一轮整段对话都在经历“全量冷启动”。正确做法是将动态时间作为环境变量追加在最新一条用户消息末尾,或让 Agent 按需调用工具查询。
2. 工具声明的动态切换与顺序漂移
有些框架喜欢按场景动态增删工具,或者序列化时未做字母序排序导致 JSON Key 顺序随机漂移。
工具声明位于历史消息之前。工具列表一旦发生顺序颠倒或增删,其后跟着的所有历史对话缓存立刻随之报废。保持固定的工具顺序对模型选择工具的能力没有影响,但对缓存命中的提升是决定性的。
3. 滑动窗口截断历史
有些系统为控制上下文长度,简单粗暴地采用滑动窗口——每次只保留最近 10 轮消息。
这是极具迷惑性的毒药。单次看输入 Token 下降了,但滑动窗口每轮都在切掉最早的一条消息,导致整段请求的前缀每一轮都在变,前缀缓存彻底无法复用。
前期关键的工具调用证据被静默丢弃后,Agent 只能盲目猜测,陷入反复调用同一个工具的死循环。
4. 篡改历史消息与 Thinking 块
为了节省上下文,中途修改历史消息(如截断某次工具输出或删改上一轮模型的思考过程),会直接破坏前缀一致性,导致断点之后的缓存全部作废。
反直觉的实测结果:优化比例不可相加
多数人直觉地认为:把各项上下文优化手段叠加起来,效果就会成倍提升。
实测给出了相反的结论。在一组标准的 8 轮任务对照实验中,分别开关“稳定前缀”和“压缩历史”,数据如下:
| 方案 | 输入 Token | 缓存 Token | 比基线节省 |
|---|---|---|---|
| 无缓存、无压缩 | 20,700 | 0 | — |
| 仅稳定前缀 | 20,386 | 13,568 | 28.3% |
| 仅压缩历史 | 16,177 | 0 | 17.5% |
| 稳定前缀 + 压缩 | 16,035 | 6,144 | 30.0% |
算术相加:28.3% + 17.5% = 45.8%。但双管齐下实测只有 30.0%。
因为压缩历史的同时,也缩短了可以命中缓存的前缀长度。
两项优化在争抢同一块收益。在设计上下文策略时,必须做全链路端到端实测,不能把单项指标简单相加。
上下文分层冻结架构
生产级 Harness 必须把缓存作为前置约束,遵循上下文分层冻结纪律:
[第 1 层:绝对静态区]  -> 全局不可变 System Prompt(严禁动态变量)
[第 2 层:稳定工具区]  -> 按名称严格字母序排列的 Tool Schemas
[第 3 层:基础知识区]  -> 仓库全局规范与稳定上下文(快照一次性加载)
[第 4 层:纯追加历史]  -> 历史消息序列(严格 Append-Only,绝不中途篡改)
[第 5 层:动态临时区]  -> 当前时间、瞬态环境变量(作为最新 User 消息末尾 Addon)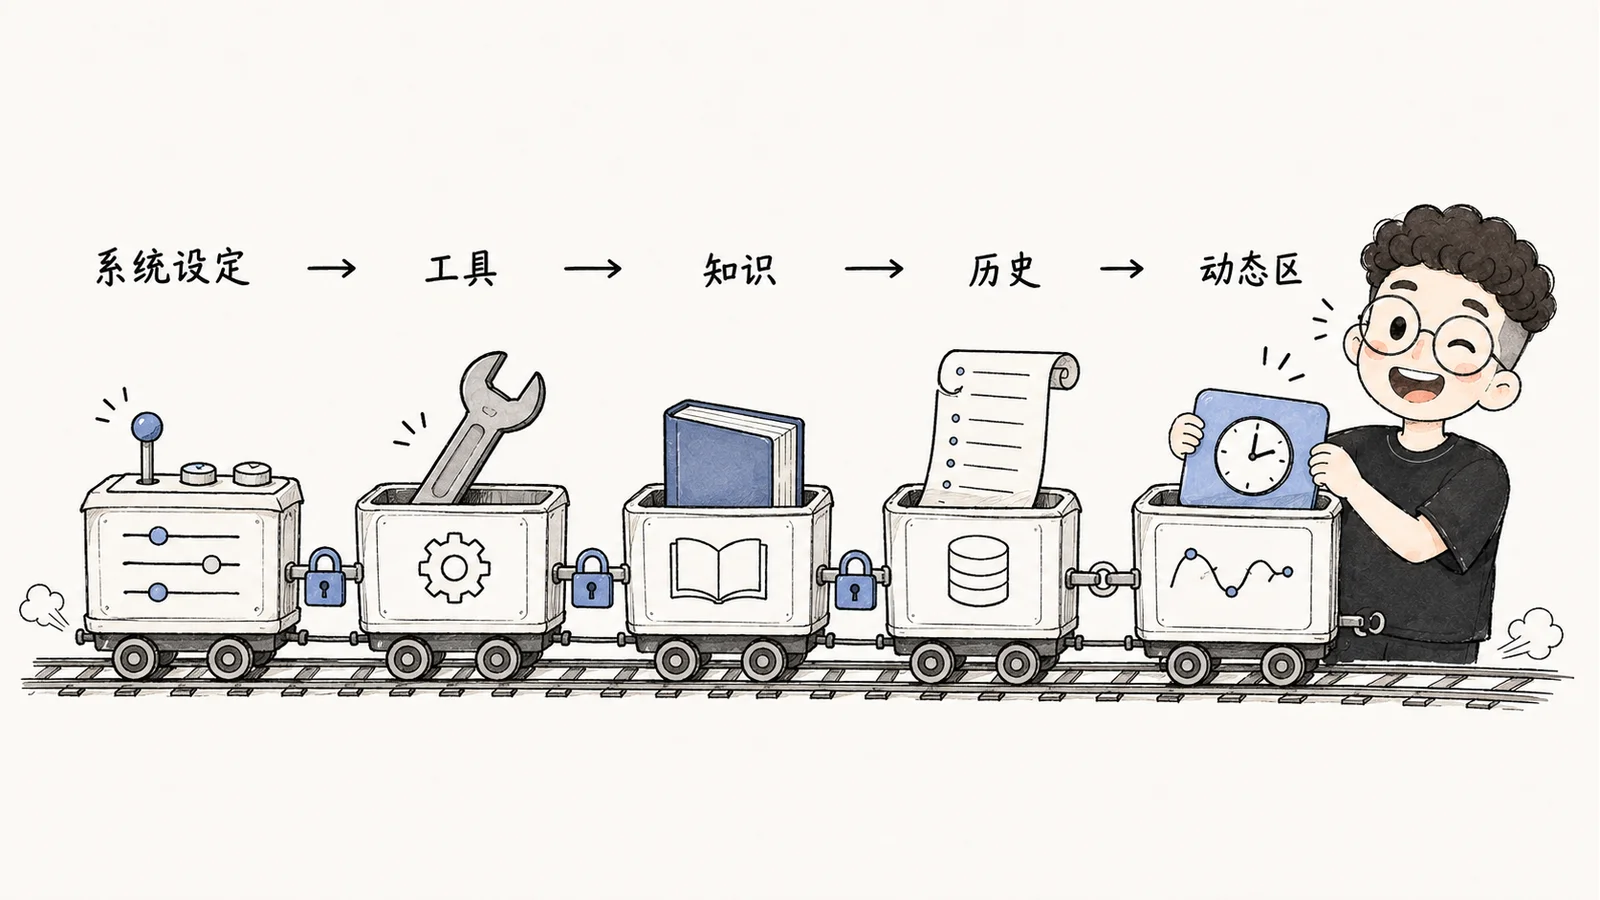
前 3 层在跨会话中保持绝对静态。变动只发生在最末尾的第 5 层,核心系统设定与历史上下文依然能吃到显存的缓存加速。
当主 Agent 派生子 Agent 时,提示词与工具定义必须逐字节对齐,避免子 Agent 被迫发起昂贵的全量冷启动。
开发 Agent 时,建议在每次收到 API 响应时,把 cached_tokens / total_tokens 的命中比例打印在终端上。
前缀缓存是编写 Prompt 时的第一道物理边界。 当你发现 Agent 越来越慢、账单暴涨时,先去排查系统提示词开头是否又随手塞进了一个 new Date()。