
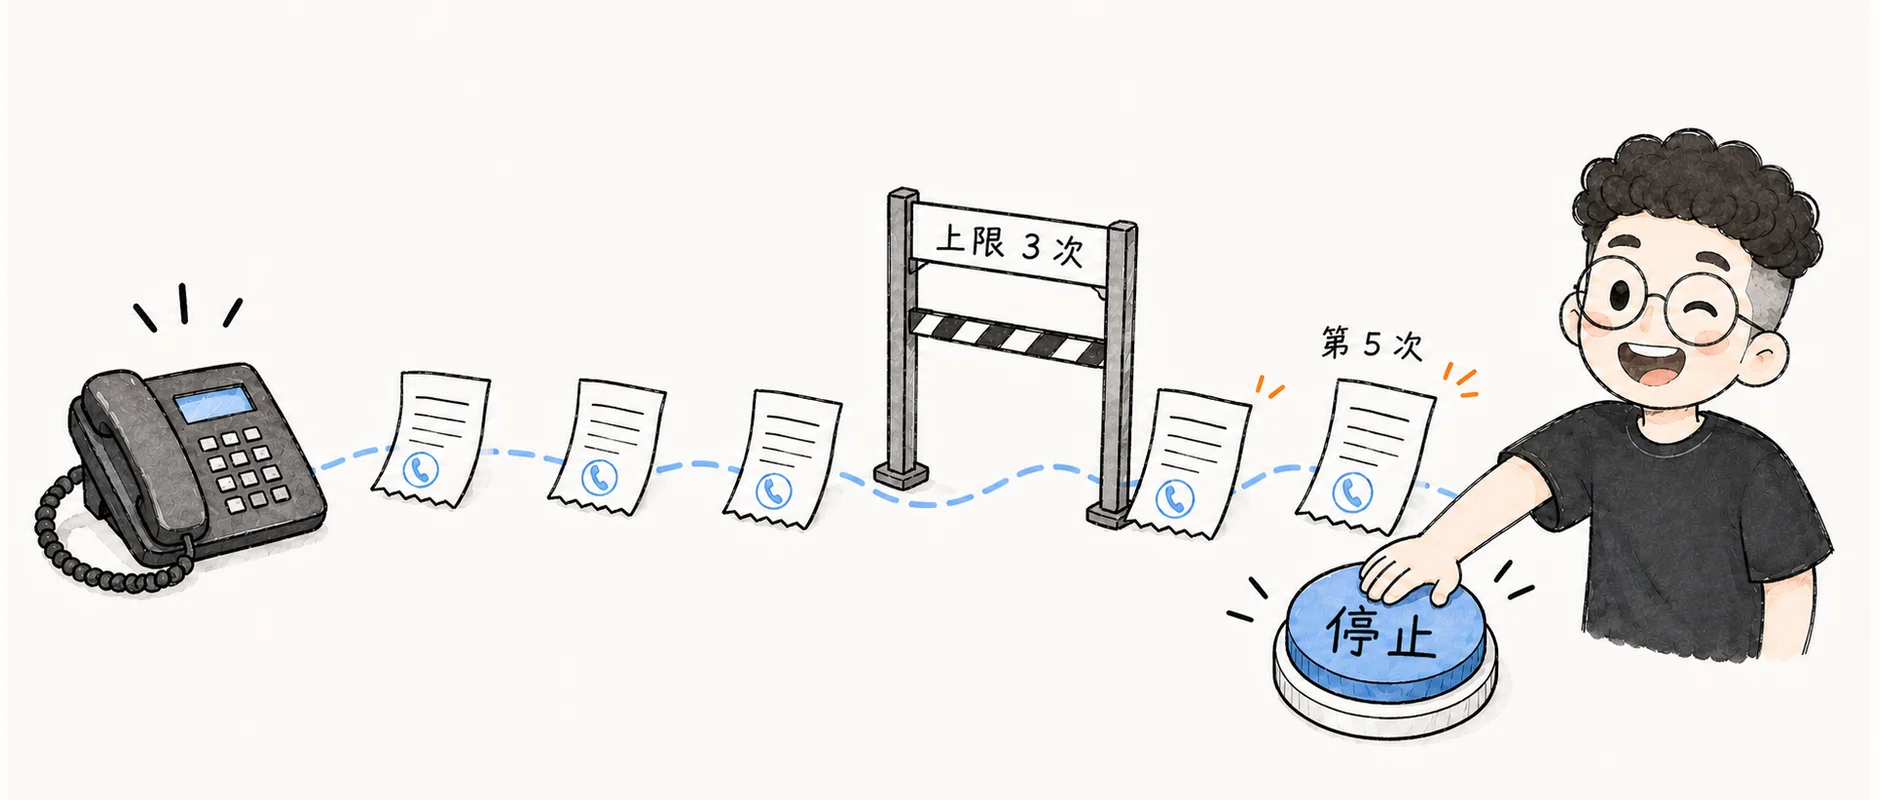
上周测试一个自动外呼与退款核销的 Agent。
为了防止骚扰用户,我们在 System Prompt 里写了明确的硬性规则:“对同一个商家的拨打尝试,不得超过 3 次”。
会话跑起来之后很顺利,前 3 次拨打均因对方占线而挂断。打开上下文日志,前 3 次通话的时间、返回码和失败原因记录得一清二楚。
但在第 4 轮迭代中,Agent 毫无迟疑地再次调用了拨打工具,一路打到了第 5 次,直接把测试号码打进了运营商的风控黑名单。
规则白纸黑字写在开头,事实清清楚楚记在眼前,调用的也是顶级的商用大模型。为什么它连“三”都数不清?
很多开发者遇到这种问题,第一反应是去改提示词:“务必严格数清调用次数”、“千万不要超过三次”。
但改完之后,它依然会偶发性地数错。
这不是提示词写得不够严厉,而是撞上了 Transformer 注意力机制的硬限制。
上下文窗口原生缺失状态聚合层
很多人习惯把上下文窗口当成模型的“工作内存”,以为放进去的内容模型都能随时计算。
但从底层机制看,上下文学习(In-Context Learning)主要负责检索,并不负责状态维护。
注意力机制擅长做的事,是从成千上万个 Token 里把相关的原始片段找出来。但它原生缺失了一层:状态聚合。
上下文中记录的信息,模型不会自动计数,更不会就地累加。
一个简单的实验就能说明这种差异:
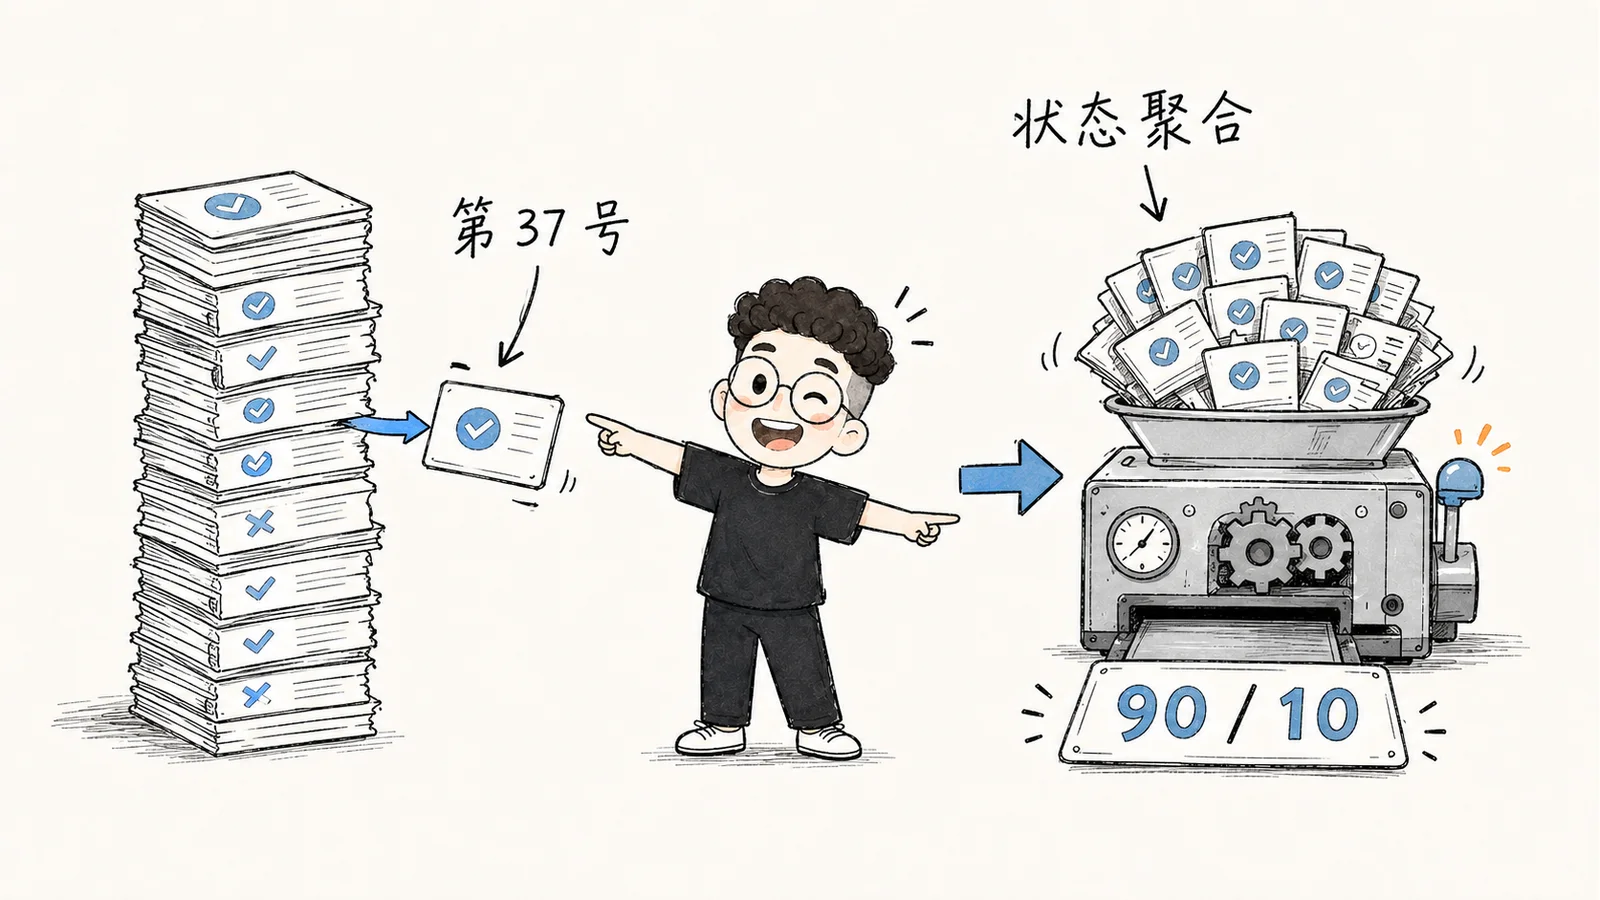
在上下文里塞入 100 篇巡检记录,其中 90 篇标明设备正常,10 篇标明异常。
如果问它:“第 37 号设备的巡检状态是什么?” 注意力机制可以精准定位,答案毫无偏差。
但如果问它:“正常和异常的设备各有多少台?” 在不开启思维链逐行排查时,模型极容易数错。
回答第一问只需要做模式匹配检索;回答第二问则需要遍历全量记录并维护累加状态。这是典型的带状态计算。
当会话进行到十几轮、上下文中塞满代码和工具输出时,让模型在单次前向传播里精准数出某个工具调了几次,无异于强求一个搜索引擎去心算账本。
把隐式计算,变成确定性的状态栏
既然概率模型不擅长自发数数,工程上的解法就非常纯粹:绝不要把状态统计的工作留给模型。
最直接的工程解法,是由 Harness 在每次交互时用确定性代码提前算好高阶状态,在上下文末尾挂上 Agent 状态栏(Agent Status Bar)。
在外呼场景里,当 Harness 在每次工具返回的末尾显式注入一句“本次是该商家第 3 次呼叫(已达最大上限 3/3)”,模型就能瞬间命中规则边界,终止拨打,错误率直接归零。
状态栏机制带来了两项工程收益:
第一,提高信噪比。原始的工具执行日志充斥着大量低价值 Token,状态栏用几十个 Token 的代价,直接向模型提供原本需要扫描数千 Token 才能提取的统计结论。
第二,缩短注意力跨度。在长会话中,模型的注意力极易被滚动的日志稀释。把算好的元状态放在上下文最末端,紧挨着模型即将生成的下一个 Token,能获得最确定的注意力权重。
思考开销从线性膨胀,收敛为基本恒定
状态栏机制带来的提升,在实验数据中体现得非常剧烈。
研究人员基于注意力分布和思考 Token 做了对照实验:
- 无状态栏:模型的注意力高度分散在各个历史工具调用的片段中,思考过程充斥着反复扫描上下文、数数和对账的动作。每次查询所需的思考 Token 量,随着会话轮次和上下文长度线性持续增长。
- 有状态栏:注意力高度聚焦在状态栏的提炼信息上,思考过程直接消费现有结论。单次迭代的思考 Token、响应延迟和 API 花费降低了近一个数量级。
更关键的是:加入状态栏后,模型单步思考的开销从随上下文变长而线性膨胀,收敛为基本恒定。
这种收敛是决定性的。它意味着一个长程任务不会因为跑到第 20 轮就由于思考膨胀而拖垮性能。甚至较小的开源模型在挂上状态栏后,任务完成率也能直接逼近前沿大模型。
状态栏里最该放的 3 样东西
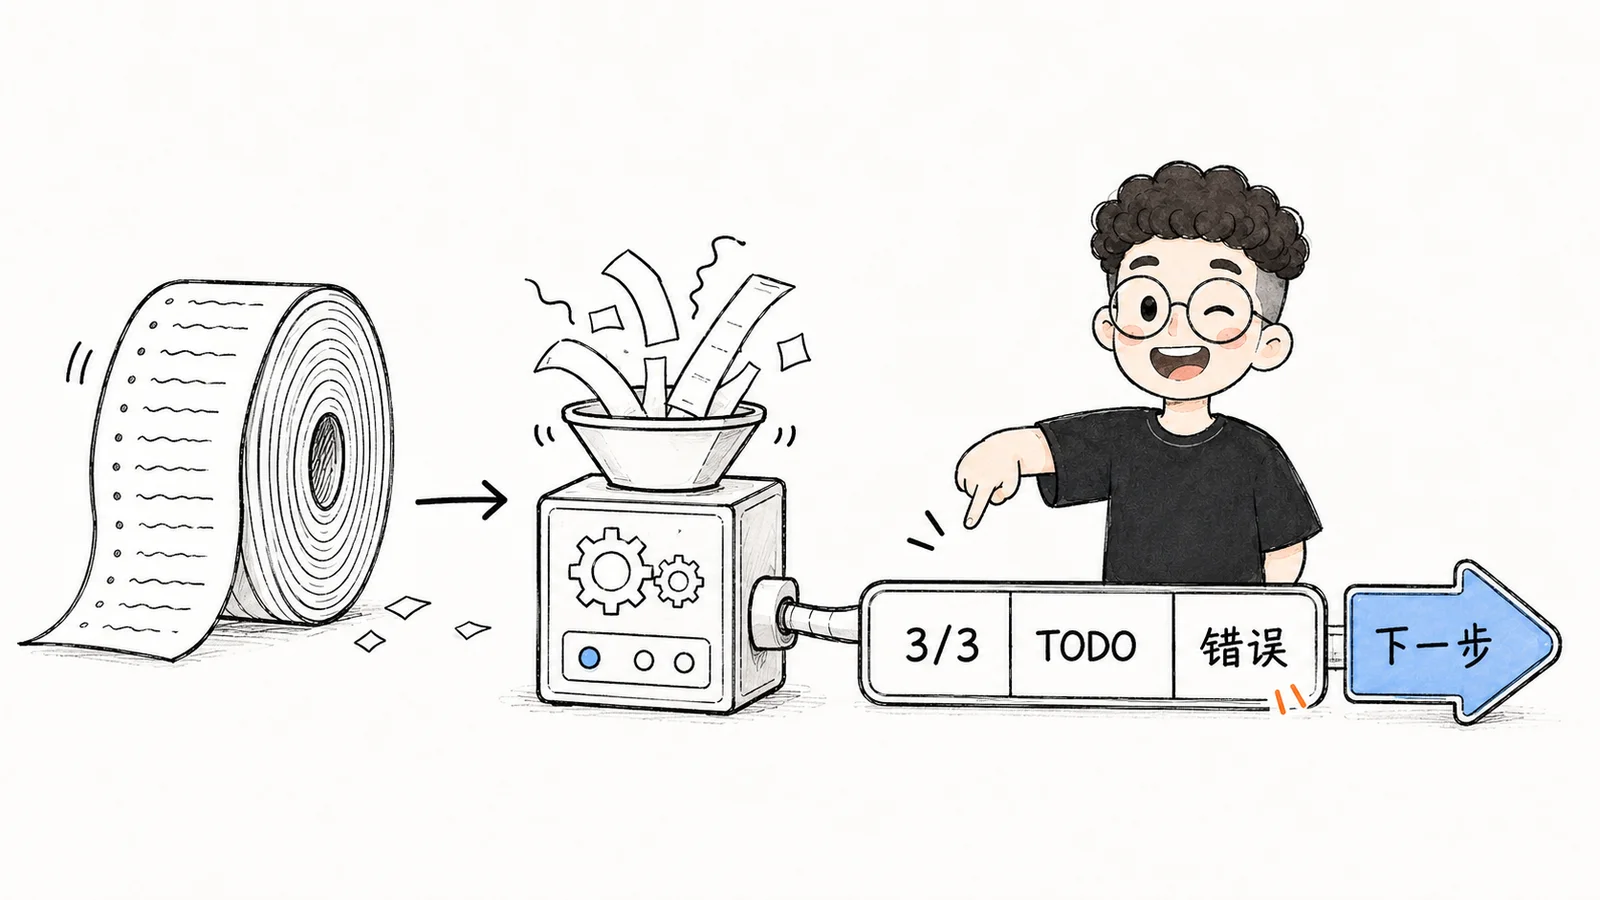
在写 Harness 状态栏时,有三类信息被证明拥有最高的工程杠杆:
1. 工具调用计数器
在工具返回结果中,由 Harness 维护一个计数,标明“这是该工具的第 N 次调用”。
当同一个工具在短时间内连续失败 2 到 3 次时,计数器能迅速触发模型的模式识别:第一次失败它会检查路径,第二次它会查看目录,第三次它会主动放弃死磕,转去寻找替代方案。
2. 显式的 TODO 列表
在上下文末尾维护结构化的任务清单,每轮刷新每一项的状态(pending / in_progress / completed)。
实测表明,启用显式 TODO 列表后,Agent 完成长任务所需的平均迭代轮次从 21 轮下降到 15 轮,且极少出现“做完第一件事就把第二件事忘了”的过早终止现象。
3. 结构化错误与修复建议
很多系统在工具报错时,只把原始的 stderr 扔回给模型。
高质量的状态栏会对错误做分层包装:错误类型、调用参数、调用栈,以及由 Harness 预设的针对性修复建议(比如“文件不存在,可尝试使用 fffind 搜索文件名”)。
在测试中,这一项改动把 Agent 找到正确替代方案的成功率直接从 60% 提升到了 95%。
两条必须遵守的实现边界
在实现状态栏时,必须守住两条工程底线:
第一,注入位置必须挂在末尾。状态栏应当借用 user 消息的角色槽位追加在对话最后,或者放在最新工具返回的末尾。绝对不能为了“看起来整洁”去修改开头的 System Prompt,否则每一轮状态更新都会击穿前面的前缀缓存。
第二,模型对状态栏近乎盲目采信。实验表明,模型极度信任上下文末尾的状态投影。如果你的 Harness 计数器代码有 bug(比如实际上调了 2 次却写成了 3 次),模型就会毫不怀疑地依据错误计数做出判断。
写给模型的统计数据,必须由绝对可靠的确定性代码来保证。
大模型专精于语义关联与生成,无法替代精准的计数器。
不要指望把所有事情都丢给模型去“心算”。让确定性代码负责算术与状态投影,让大模型专注逻辑与语义推理,这才是生产级 Agent 系统最稳固的底座。