
这两天把一个长期跑在后台的 Coding Agent 停掉了。
刚给它配上自动记忆(Auto-Memory)和自演化技能的时候,它确实表现得很聪明:记住了我偏好的目录结构,学会了按团队规范给 PR 打标签,还会根据报错经历自己写辅助脚本。
但跑了三周之后,它的行为开始飘忽不定。
提一个两行的小改动,它会突然弹窗三次反复确认;涉及核心数据库迁移时,它却一言不发直接把代码推上了分支。
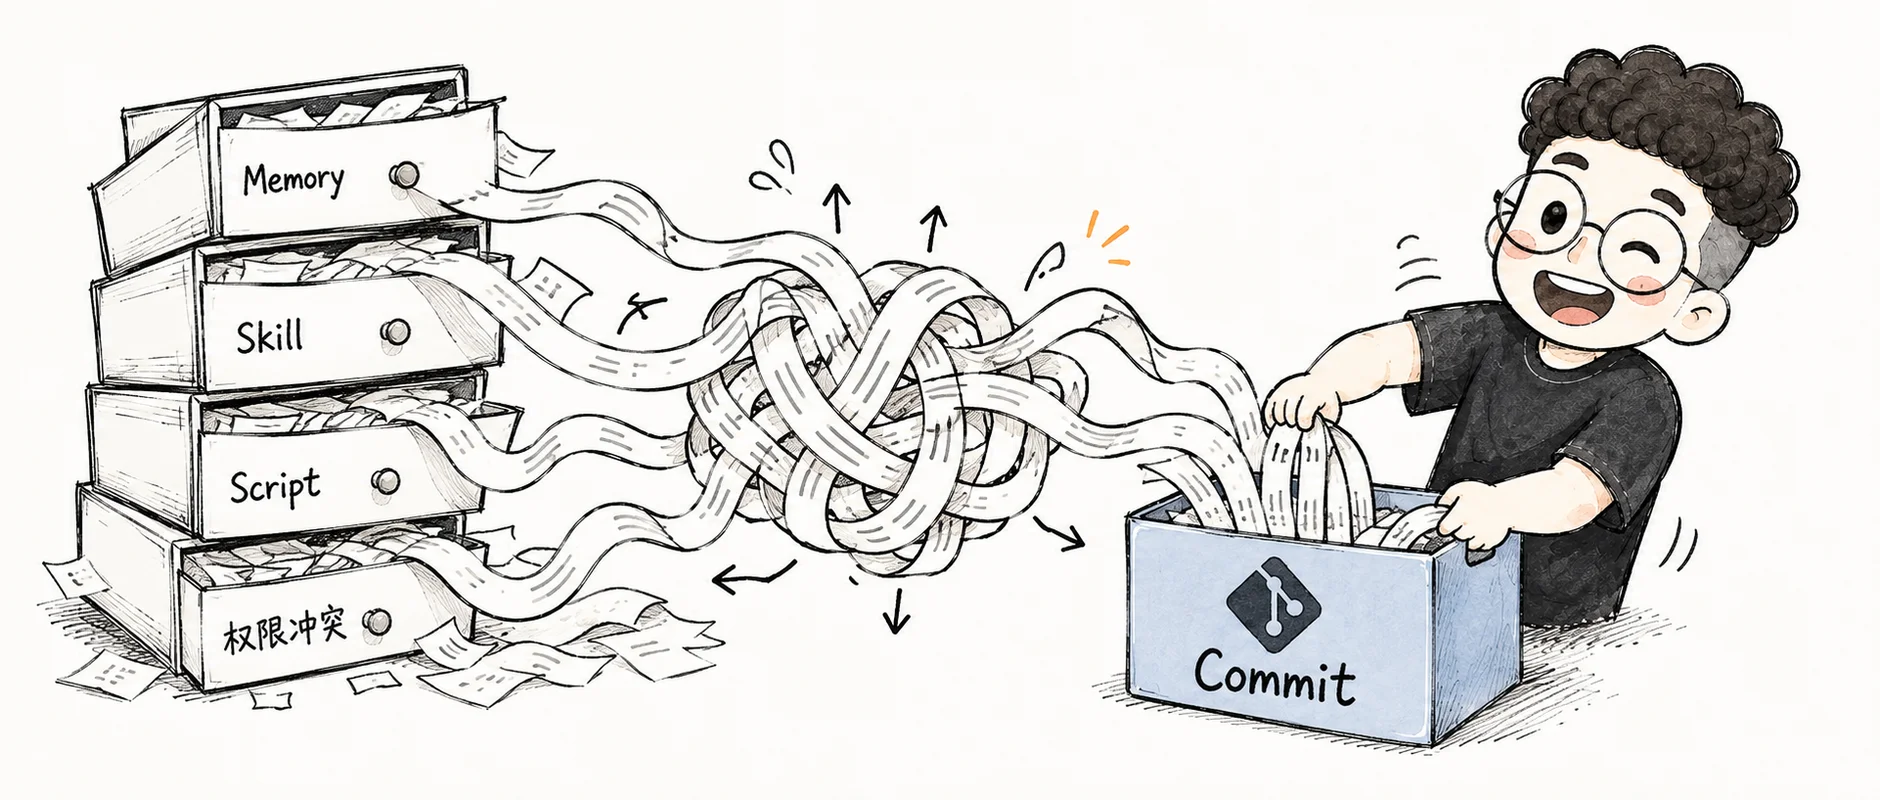
翻开它的配置目录,里面已经乱成一团:
MEMORY.md里记着上周的偏好:“用户不喜欢被频繁打扰,常规修改自动通过”;- 某个 Review Skill 文件里写着前天的指令:“修改文件前必须向用户确认风险”;
- 另外还有一个自动生成的检查脚本,里面硬编码了一个过期的权限参数。
这几个文件单独看都没写错,但拼在一起喂给模型时,模型每一步都在规则冲突里艰难平衡。你查不出它现在的状态到底是从哪一轮修改开始崩坏的。
只做追加的记忆系统不仅不会持续进化,反而会迅速累积出严重的状态失谐。
无序追加记忆必然引发规则互斥
很多 Agent 框架对长期记忆的理解还停留在“记事本”阶段。
每次对话结束,后台起一个 Summarizer 往 MEMORY.md 追加几条用户偏好。用户今天说“多写注释”,它加一条;明天说“注释太啰嗦全删掉”,它又加一条。
时间一长,模型上下文里就会堆满互相矛盾的断言:既要求“遇到复杂逻辑补充行内注释”,又要求“保持代码精简禁止多行注释”。多条互斥规则放在同一个 Prompt 里,Agent 只能靠模型临场随机猜。
更棘手的是,现代 Agent 的状态从来不是一段纯文本。一个严肃参与工程的 Agent,其状态包含长期事实、工作流规约、自建辅助脚本与权限配置。
当 Agent 尝试自我进化去改进某项能力时,它可能更新了 Skill,写了一半脚本,修改了权限,但定时任务中断了。
此时 Agent 就会进入一种“半升级状态”:没有一个文件是损坏的,但整个系统已经彻底失谐。
状态管理需要版本控制纪律
在软件工程里,管理复杂系统状态早有成熟范式:
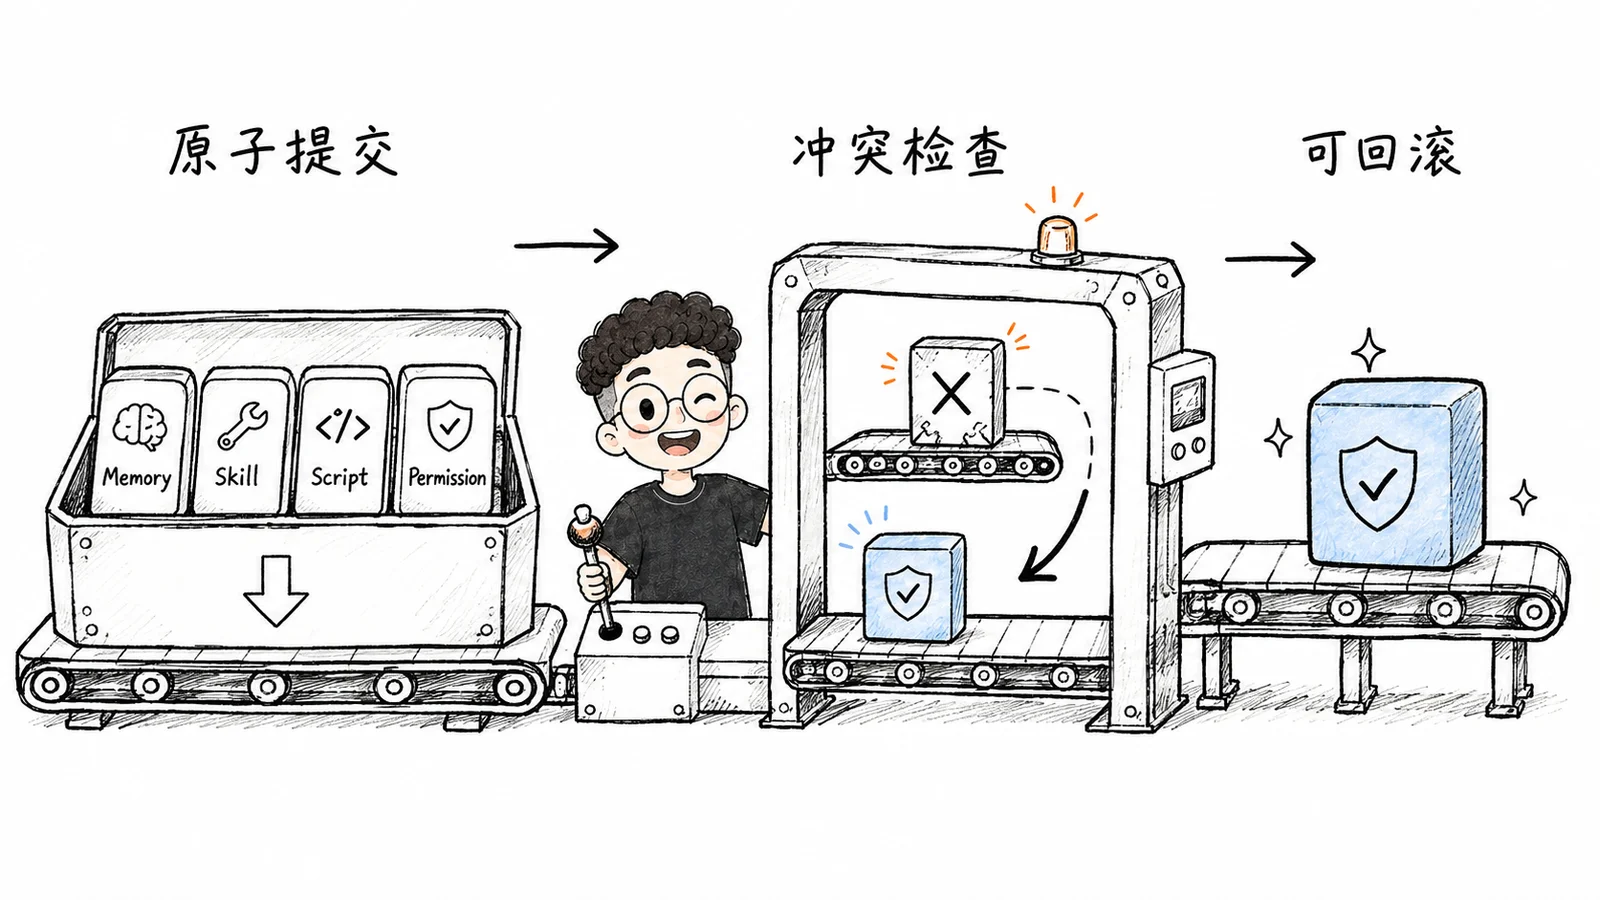
一组关联文件的修改需要原子提交,要么全部生效,要么全部不生效;运行中的任务需要快照隔离,不受中途写入的干扰;两条互斥规则必须在提交前被显式检测并仲裁;一旦新配置表现劣化,系统必须能精准回滚。
一个长期运行的 Agent,对自身状态的每一次修改都应当是一次严谨的版本演进,绝不能直接在原文件上做黑盒覆写。
目前一些前沿框架已经开始尝试会话快照隔离:当 Session 启动时冻结当前时刻的记忆快照,会话中途产生的新记忆排队进入下一个周期,保证单次会话的认知底座稳定。
但这依然不够。真正的状态管理,必须把校验做在生效之前。
可靠 Agent 的三套版本机制
把版本控制思想引入 Agent 自我演化,系统需要守住三套机制:
1. 跨维度的原子升级包
当 Agent 决定更新某项业务能力时,涉及的 Memory、Skill、辅助脚本与权限必须被打包进同一个原子提交:
Commit 3a7f9c2: upgrade(pr-review): switch to AST-based diff analysis
- memory: update reviewer preference
- skills/review.md: add ast-check step
- scripts/parse-ast.py: create helper
- permissions.json: grant exec for parse-ast.py
只有当改动全部通过语法检查与沙箱验证后,变更才会合入主干对后续任务生效。任何一步失败,整批修改立刻回滚。
2. 规则冲突的提交前检测
规则冲突的仲裁权绝不能推给模型的推理阶段。
在 Agent 尝试写入新规则或修改 Skill 时,Harness 应当调用冲突检测器,检查新指令是否与现有库里的规则存在直接互斥。
如果发现冲突,系统必须显式发出告警,在提交时附带消解动作(例如显式废弃旧规则),而不是把矛盾的指令同时塞进上下文。
3. 分支实验与能力回滚
引入全新工作流时,不需要直接在生产环境冒险。可以给 Agent 的状态拉一个独立分支:
agent checkout -b experimental-refactor-v2让它在分支状态下独立跑 10 个测试 Issue。如果任务成功率提升,再把这套状态合并回主干;如果表现异常,一行命令就能回退到昨天的稳定状态。
AI Agent 正在从一次性对话框演变为长期驻留的工程工具。
系统不仅要学习新规则,更需要维持状态自洽。如果每一次交互只是在配置目录里无序追加,最终只会堆积成无法维护的死结。
给 Agent 堆积记忆只是第一步;用版本控制的工程纪律去管理状态演进,才是它长期可靠运转的底座。